Масштабирование систем: вертикальное, горизонтальное и шардирование баз данных
Масштабирование системы затрагивает разные компоненты: приложение, очереди, кэш, хранилища. В этой статье сосредоточимся на базах данных. Разберём горизонтальное и вертикальное масштабирование, копирование данных и их распределение между узлами. Посмотрим, как выбирать подход под конкретную нагрузку и какие сложности появляются вместе с дополнительными серверами.
Содержание
- Что такое масштабирование баз данных и когда оно нужно
- Вертикальное масштабирование: простое решение с жестким потолком
- Горизонтальное масштабирование: от одного сервера к кластеру
- Партицирование: разделение данных внутри одной базы
- Шардирование базы данных: данные на разных серверах
- Маршрутизация запросов: как попасть в нужный шард
- Что делать при изменении числа шардов
- Как выбрать стратегию масштабирования: алгоритм принятия решений
- Масштабирование в контексте системного дизайна
- Заключение
Что такое масштабирование баз данных и когда оно нужно
Интернет-магазин растёт: покупателей становится больше, история заказов накапливается. Однажды страницы начинают открываться медленнее, а во время распродажи часть покупок не проходит. Поможет ли сервер помощнее? И что делать, когда возможности одной машины исчерпаны?
Масштабирование БД увеличивает возможности хранения и обработки данных при нужном времени ответа. При этом тысяча покупателей, просматривающих каталог, и тысяча сотрудников, строящих тяжёлые отчёты, создают разную нагрузку.
Технические сигналы: когда сервер перестает справляться
Первый признак — растет время ответа. Среднего значения недостаточно: оно может скрывать медленные запросы. Поэтому смотрят и на перцентили. Например, p95 в 300 мс означает, что 95% измеренных запросов завершились не дольше чем за это время.
Задержки сопоставляют с другими показателями:
- загрузкой CPU,
- использованием памяти,
- задержками дискового ввода-вывода,
- ожиданием блокировок,
- количеством соединений.
Важно также измерять пропускную способность — сколько операций система выполняет за секунду. Если очередь растёт, а число выполненных операций почти не меняется, где-то достигнут предел.
Перед изменением архитектуры проверяют планы медленных запросов, индексы, длительные транзакции и настройки пула подключений. Если оформление заказа тормозит из-за блокировки одной строки с общим счётчиком, ещё один сервер не обязательно поможет. Сначала нужно изменить способ работы с этим счётчиком.
Бизнес-сигналы: когда масштабирование становится вопросом выживания
Для бизнеса задержка превращается в проблему, когда мешает пользователю закончить действие: оплатить заказ, подтвердить бронь, отправить документ. Поэтому технические показатели связывают с требованиями продукта. Например, оформление покупки должно укладываться в заданное время даже во время рекламной кампании.
Другой сигнал — прогнозируемый рост. Перед распродажей возможности инфраструктуры проверяют нагрузочным тестом. После первых массовых ошибок времени на спокойный выбор решения и проверку переноса данных уже не будет.
Вертикальное масштабирование: простое решение с жестким потолком
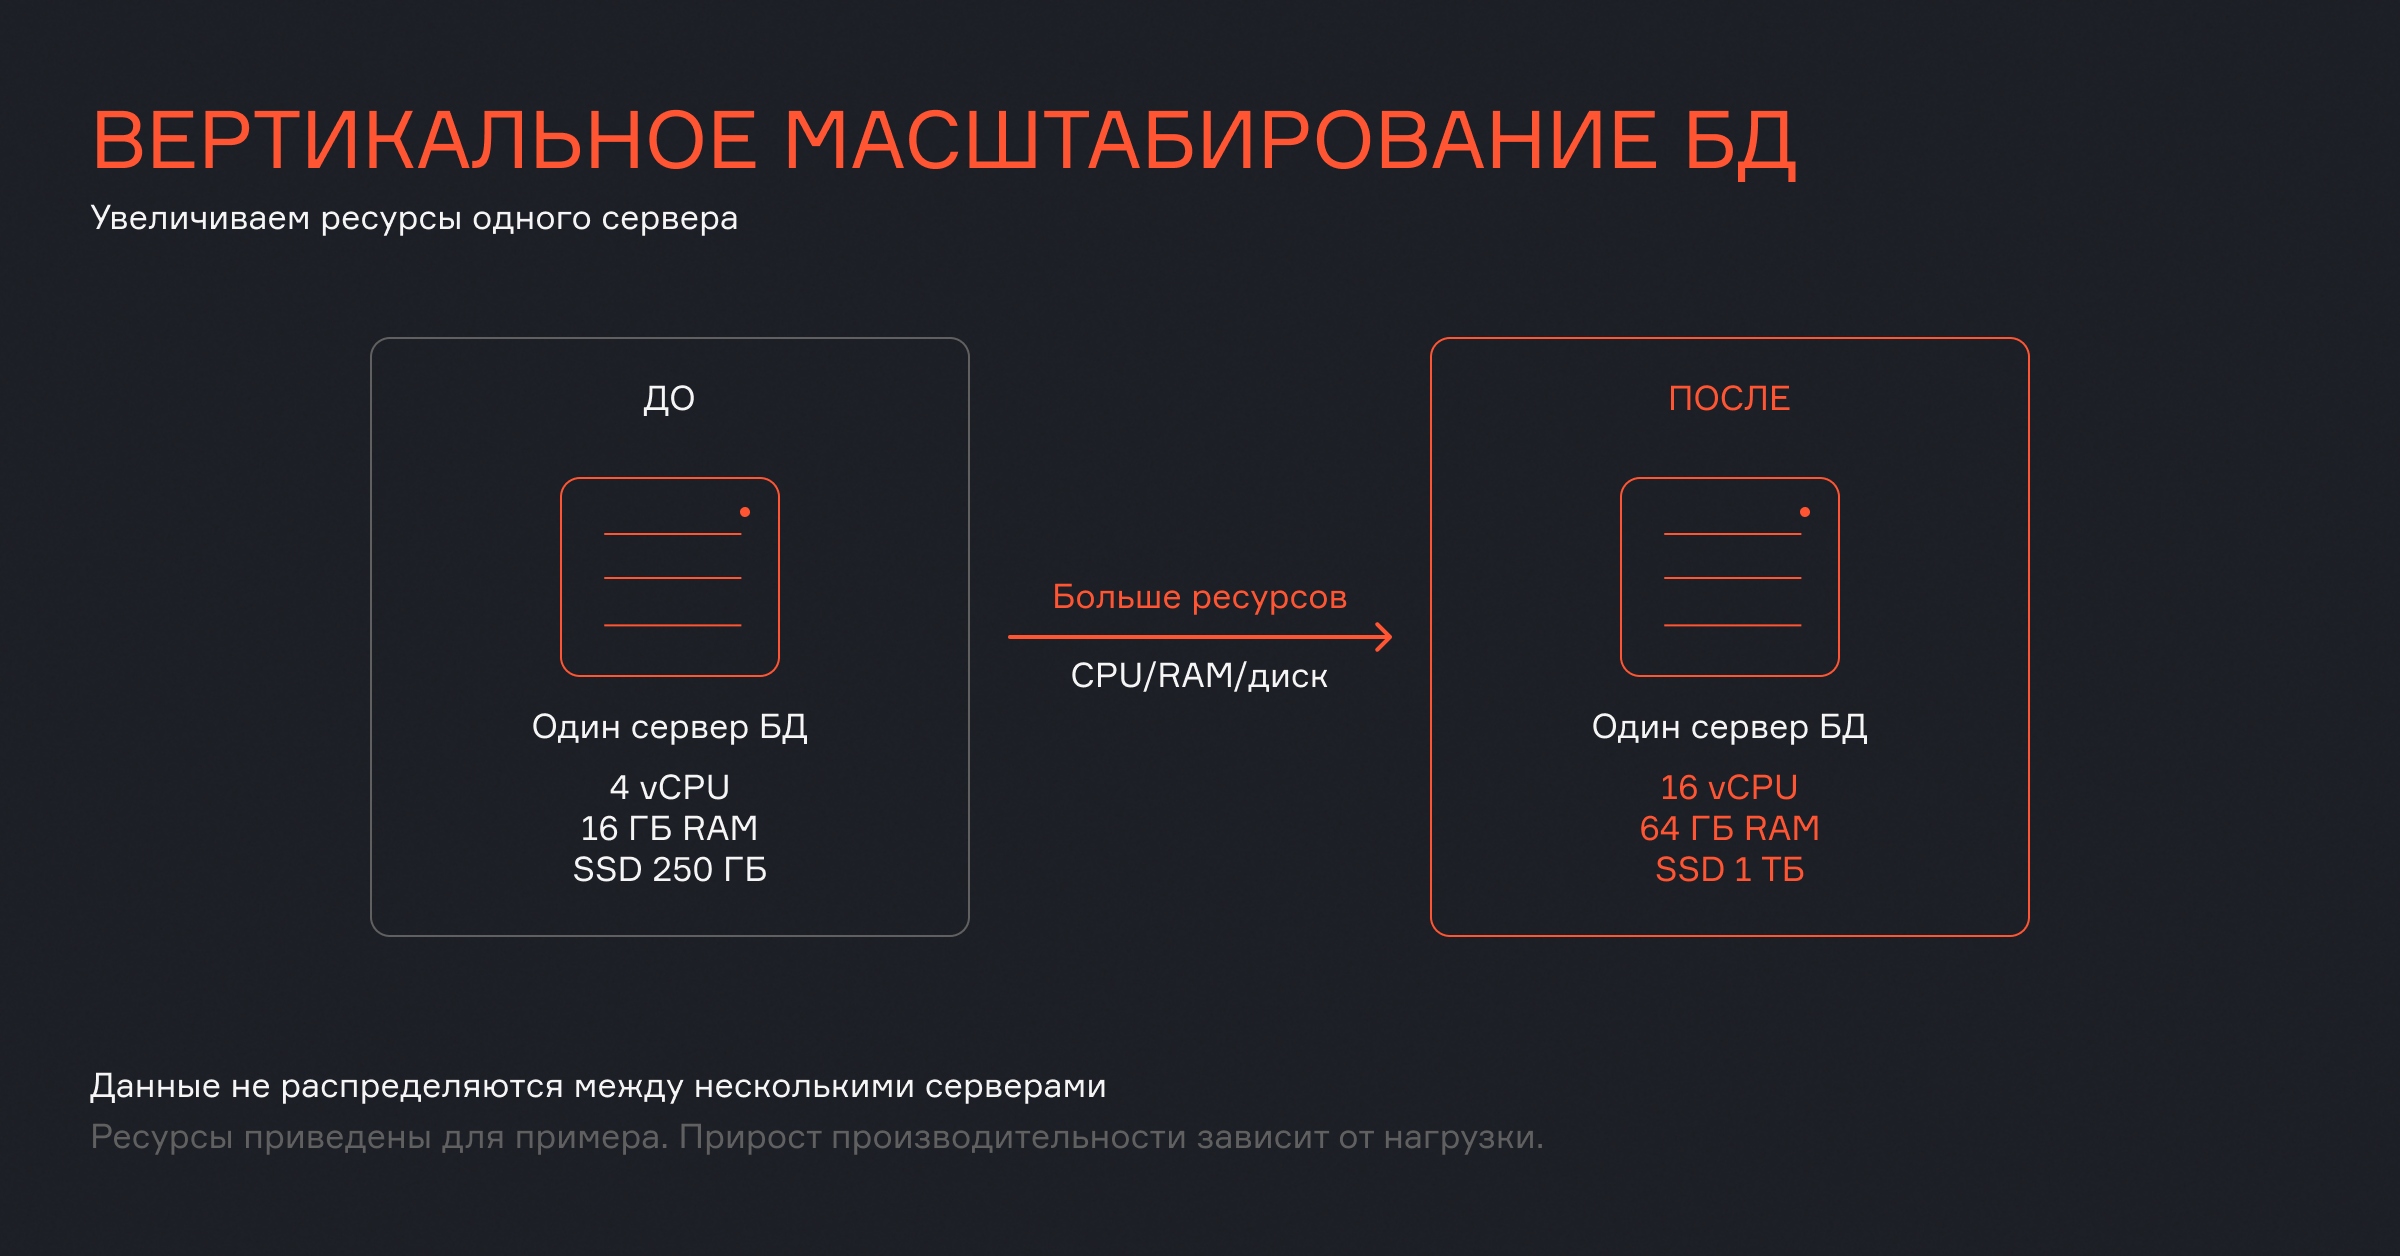
Самый очевидный способ выдержать больше запросов — дать узлу дополнительные ресурсы. Приложение обращается к той же базе, данные не нужно распределять между независимыми частями.
Как это работает
У сервера увеличивают объем оперативной памяти, добавляют вычислительные ресурсы, выбирают более быстрые накопители. В облаке это часто выглядит как переход на другой размер виртуальной машины или экземпляра управляемой СУБД. Конкретная процедура и необходимость перерыва зависят от платформы.
Каждый ресурс помогает при определенном ограничении.
- Дополнительная память позволяет удерживать больше востребованных страниц данных и индексов в кэше.
- Более быстрый диск сокращает ожидание ввода-вывода.
- Дополнительные ядра полезны, если нагрузку можно выполнять параллельно.
Преимущества и ограничения вертикального подхода
Главное преимущество — простота: база продолжает работать на одном сервере, поэтому обычно не приходится существенно менять приложение. Привычные механизмы обработки запросов и проверки целостности данных сохраняются, а команде не нужно распределять данные между несколькими машинами и согласовывать их работу.
Удвоение числа ядер не гарантирует удвоения числа заказов в секунду. Часть операций выполняется последовательно, а после устранения одного ограничения проявляется другое: например, вместо CPU начинает ограничивать диск.
Есть и физический либо тарифный потолок: бесконечно увеличивать один экземпляр нельзя. Само усиление сервера также не создает резервной копии, готовой принять нагрузку при аварии. Отказоустойчивость нужно проектировать отдельно, например с помощью резервного узла и процедуры переключения.
Когда вертикальное масштабирование — правильный выбор
Увеличивать ресурсы одного сервера разумно, если это позволяет выдерживать текущую нагрузку и оставляет запас на рост. Такой подход особенно удобен, когда операции затрагивают связанные данные: например, при оформлении заказа нужно одновременно сохранить покупку и обновить остатки товаров.
При выборе учитывайте не только цену оборудования, но и затраты на изменение приложения, сопровождение и возможные простои. Если нагрузочные тесты подтверждают, что более мощный сервер справится с ожидаемым ростом, он может стать долгосрочным решением.
Горизонтальное масштабирование: от одного сервера к кластеру
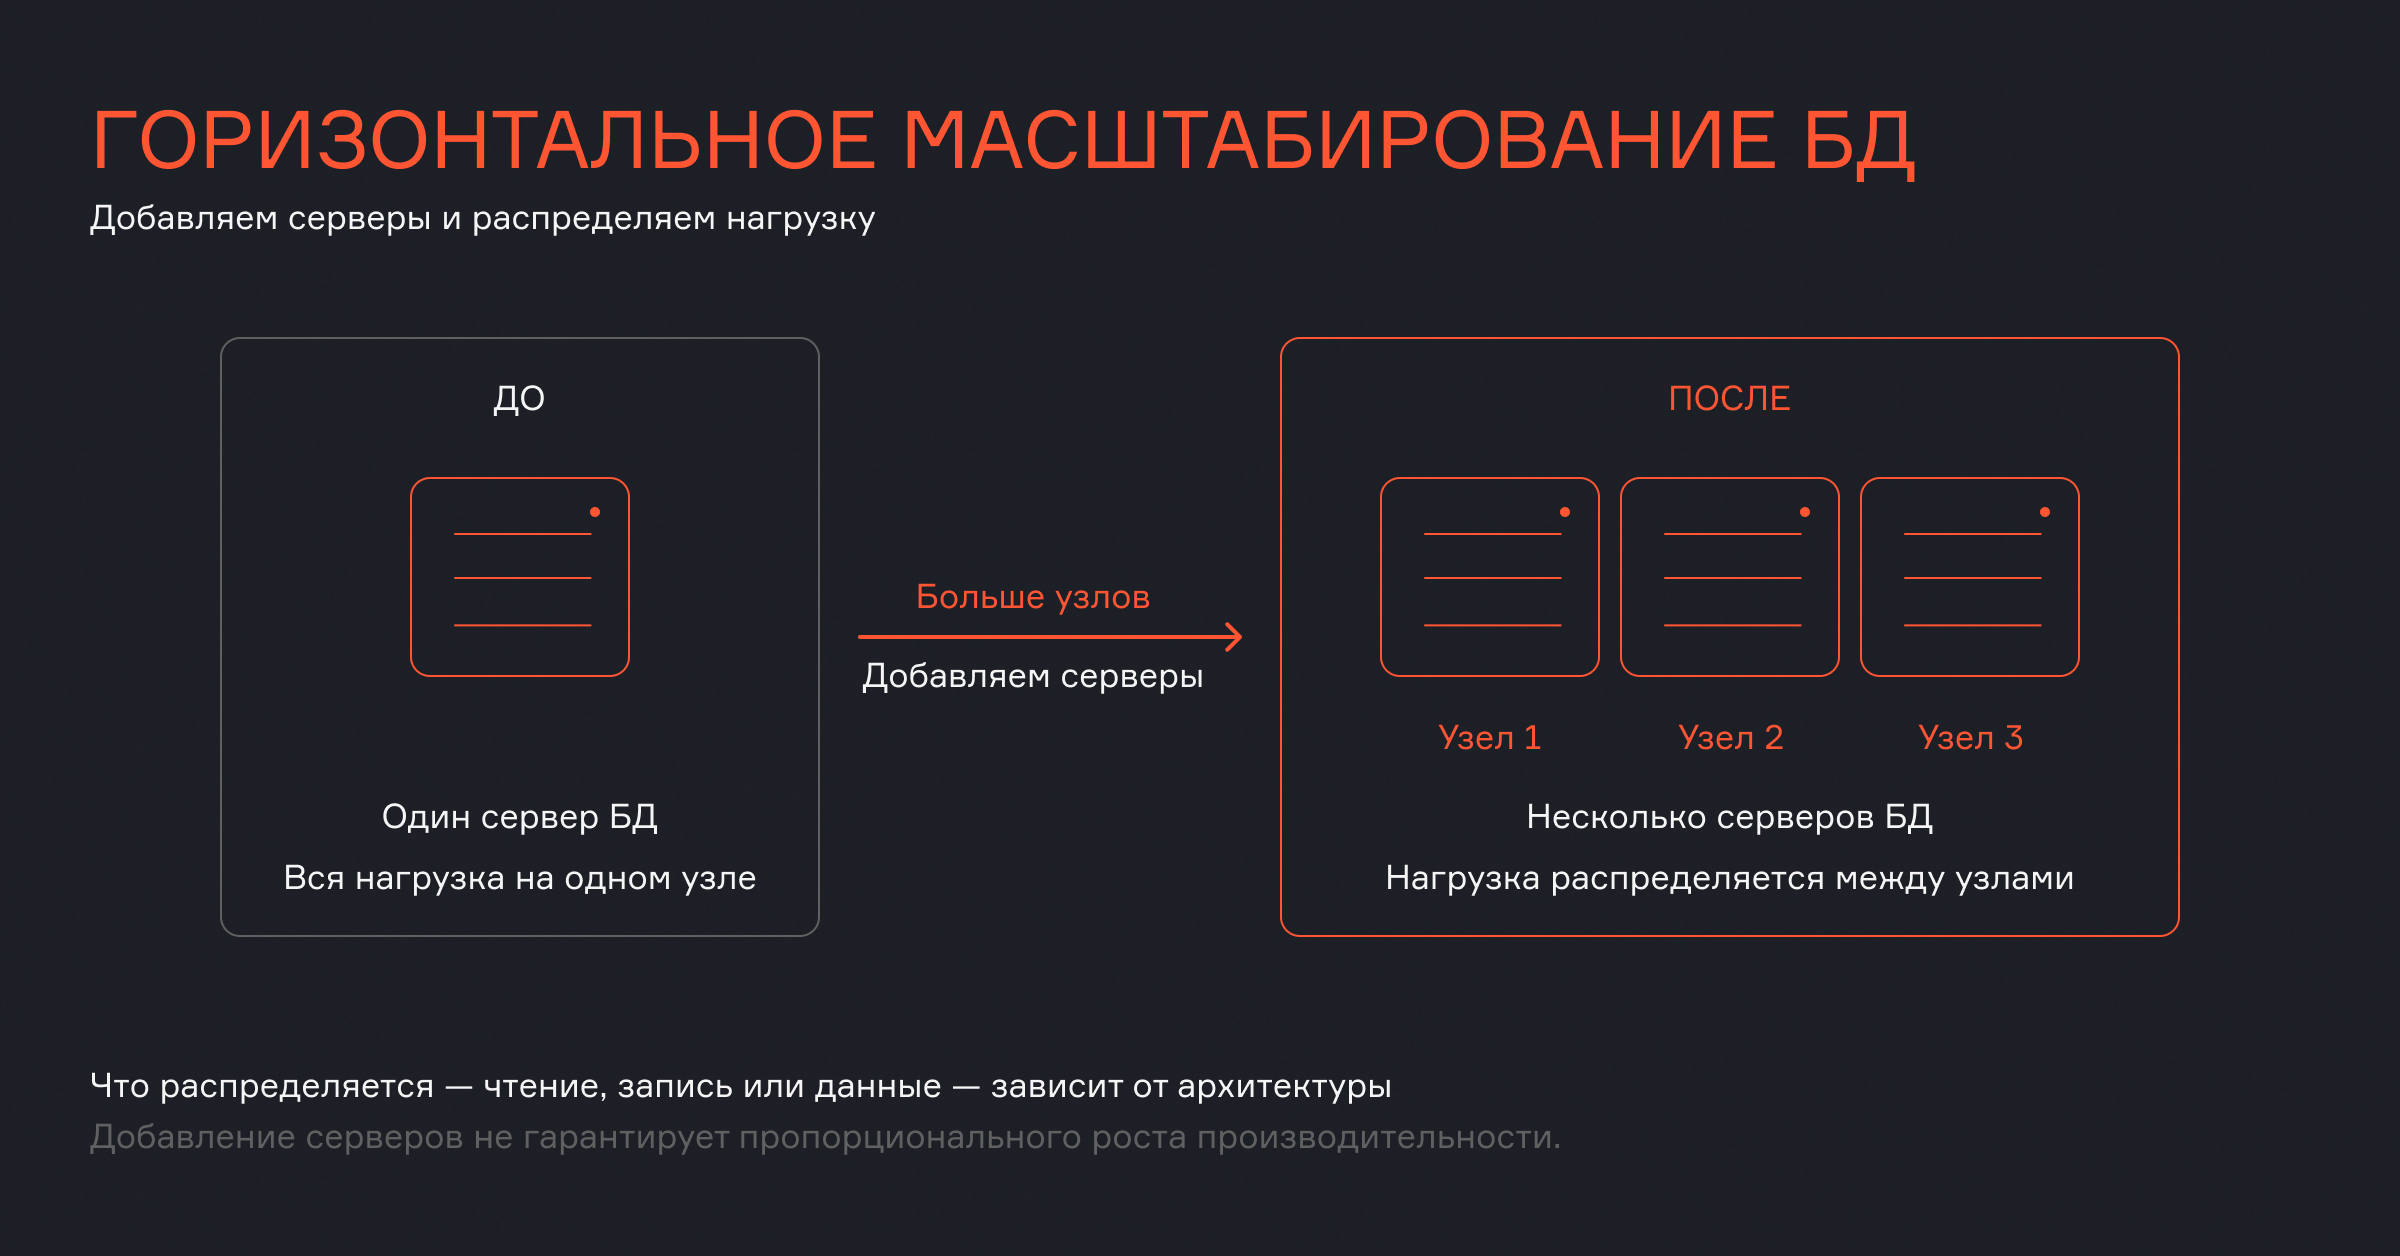
Здесь добавляют узлы, которые хранят копии одного набора данных или обслуживают разные его части. От этого зависит результат: увеличение возможностей чтения, записи или хранения.
Горизонтальное масштабирование базы данных начнём с реплик: они выносят часть чтения на дополнительные узлы и дают резерв при отказе.
Копии для отказоустойчивости и чтения
Основной сервер магазина принимает новые заказы, цены и остатки. Дополнительные узлы получают изменения и обслуживают разрешённые запросы на чтение. Так просмотры каталога меньше конкурируют с покупками за ресурсы основного узла.
При аварии можно переключиться на подготовленную копию. Для этого нужны обнаружение отказа, выбор нового основного узла и защита от независимой записи на старом. Ошибочное удаление тоже распространяется на реплики, поэтому они не заменяют резервное копирование.
Что такое репликация данных простыми словами
Чтобы понять, что такое репликация базы данных, представьте дополнительные экземпляры данных магазина. СУБД передаёт им изменения, а они применяют их к своим копиям.
Репликация данных — это процесс создания и поддержания копий данных на нескольких узлах: изменения передаются между ними, чтобы копии оставались актуальными. Она помогает распределять запросы на чтение и сохранять доступ к данным при отказе отдельных серверов. Это постоянное обновление копий, а не разовый перенос файла.
При асинхронной передаче основной узел может подтвердить запись, не дожидаясь ее применения на реплике. Покупатель уже создал заказ, а при чтении с отстающего узла еще не видит его. Для такого сценария можно читать с основного узла или использовать механизм ожидания нужной позиции репликации.
При синхронном режиме подтверждение зависит от ответа выбранных реплик. Важно уточнять, чего ждёт система: получения изменений, сохранения на диск или применения. От этого зависят гарантии и задержка.
Ограничения репликации: почему она не решает проблему записи
Речь о схеме с одним пишущим узлом и репликами чтения. Все новые заказы по-прежнему проходят через основной сервер. Если предел достигнут именно на записи, дополнительные читающие копии не разделят этот поток между собой. Хотя снятие нагрузки чтения может освободить часть ресурсов.
Репликация БД возможна и в системах с несколькими пишущими узлами. Но там нужно согласовывать параллельные изменения либо разрешать конфликты. Нельзя считать, что добавление еще одной копии автоматически удвоит скорость записи без изменения гарантий и архитектуры.
Партицирование: разделение данных внутри одной базы
Иногда проблема связана с размером конкретной таблицы. История заказов хранится за много лет, а пользователи обычно смотрят последние месяцы. Партиционирование позволяет разделить данные на управляемые части.
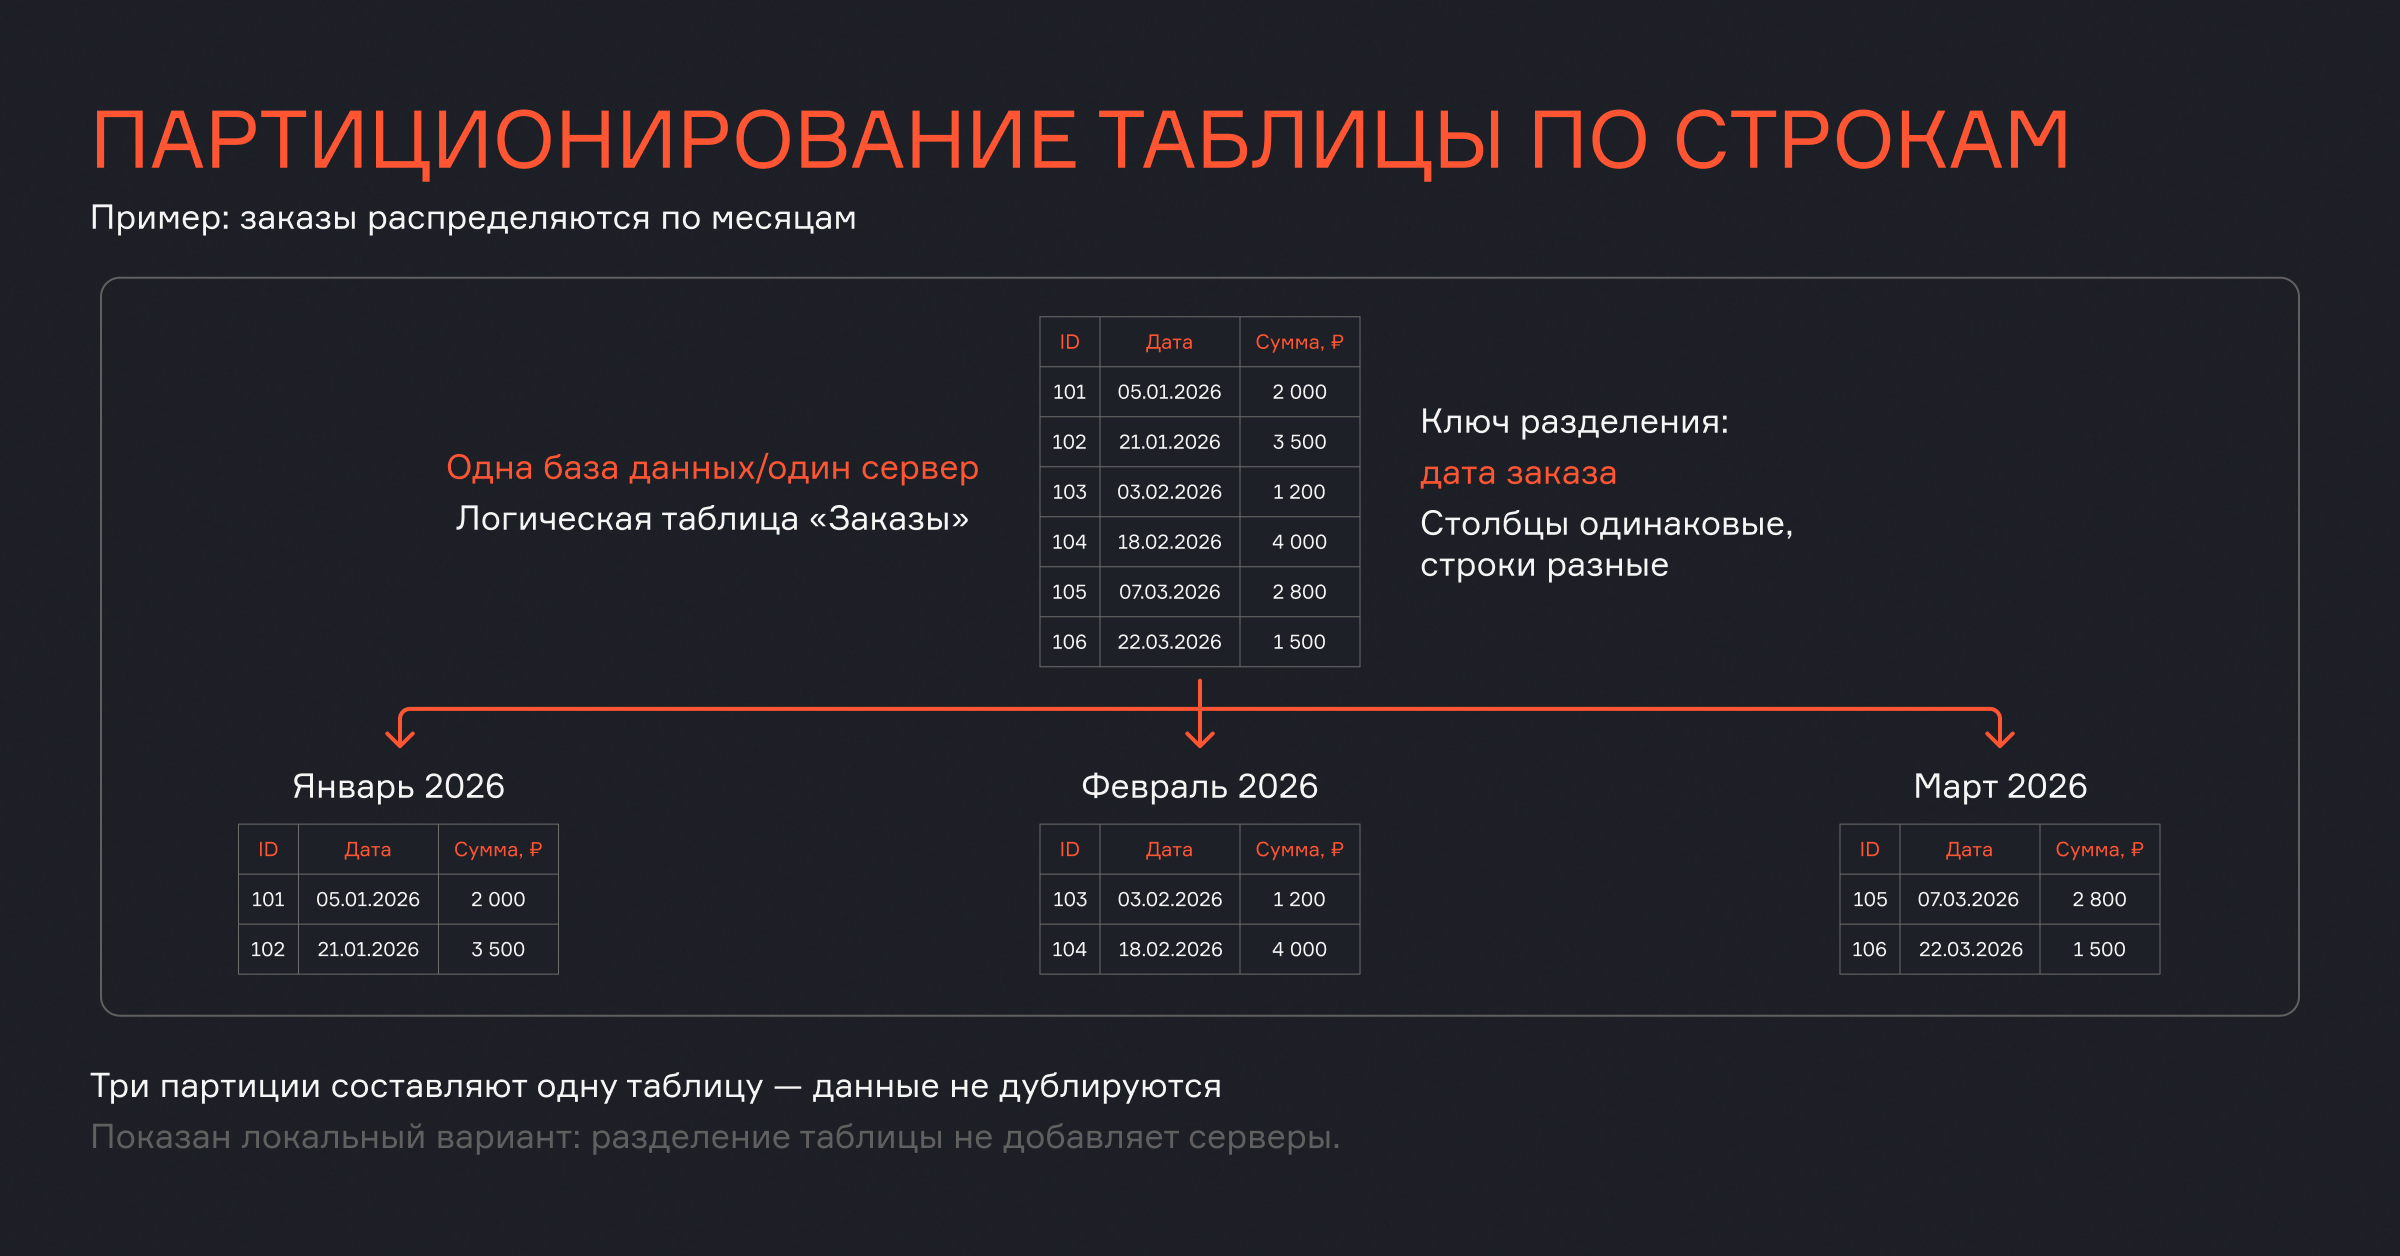
Горизонтальное партицирование: разбиение по строкам
Большую таблицу делят на части с одинаковыми столбцами. Например, заказы января попадают в одну партицию, февраля — в другую. Приложение может обращаться к общей логической таблице, а СУБД определяет, какие части нужны запросу.
Если запрос содержит условие по дате, СУБД может пропустить ненужные партиции. Такой механизм называют отсечением партиций (partition pruning). Вместо всей многолетней истории обрабатывается нужный период. Это не отменяет индексы: внутри выбранных частей поиск тоже должен быть эффективным.
Вертикальное партицирование: разбиение по колонкам
Здесь разделяют набор столбцов. Например, в карточке товара есть идентификатор, название, цена, длинное описание и дополнительные характеристики. Краткие поля нужны почти при каждом просмотре каталога, а подробные — только при открытии карточки.
Можно хранить основные сведения в одной таблице, подробности — в другой, связав их по идентификатору. В зависимости от устройства хранения это сокращает чтение для частых операций. Но для получения полной карточки потребуется соединить части или выполнить несколько запросов.
Шардирование базы данных: данные на разных серверах
Когда ресурсов одного узла недостаточно, данные распределяют. Каждый участник обслуживает свою часть, а система направляет обращения владельцу.
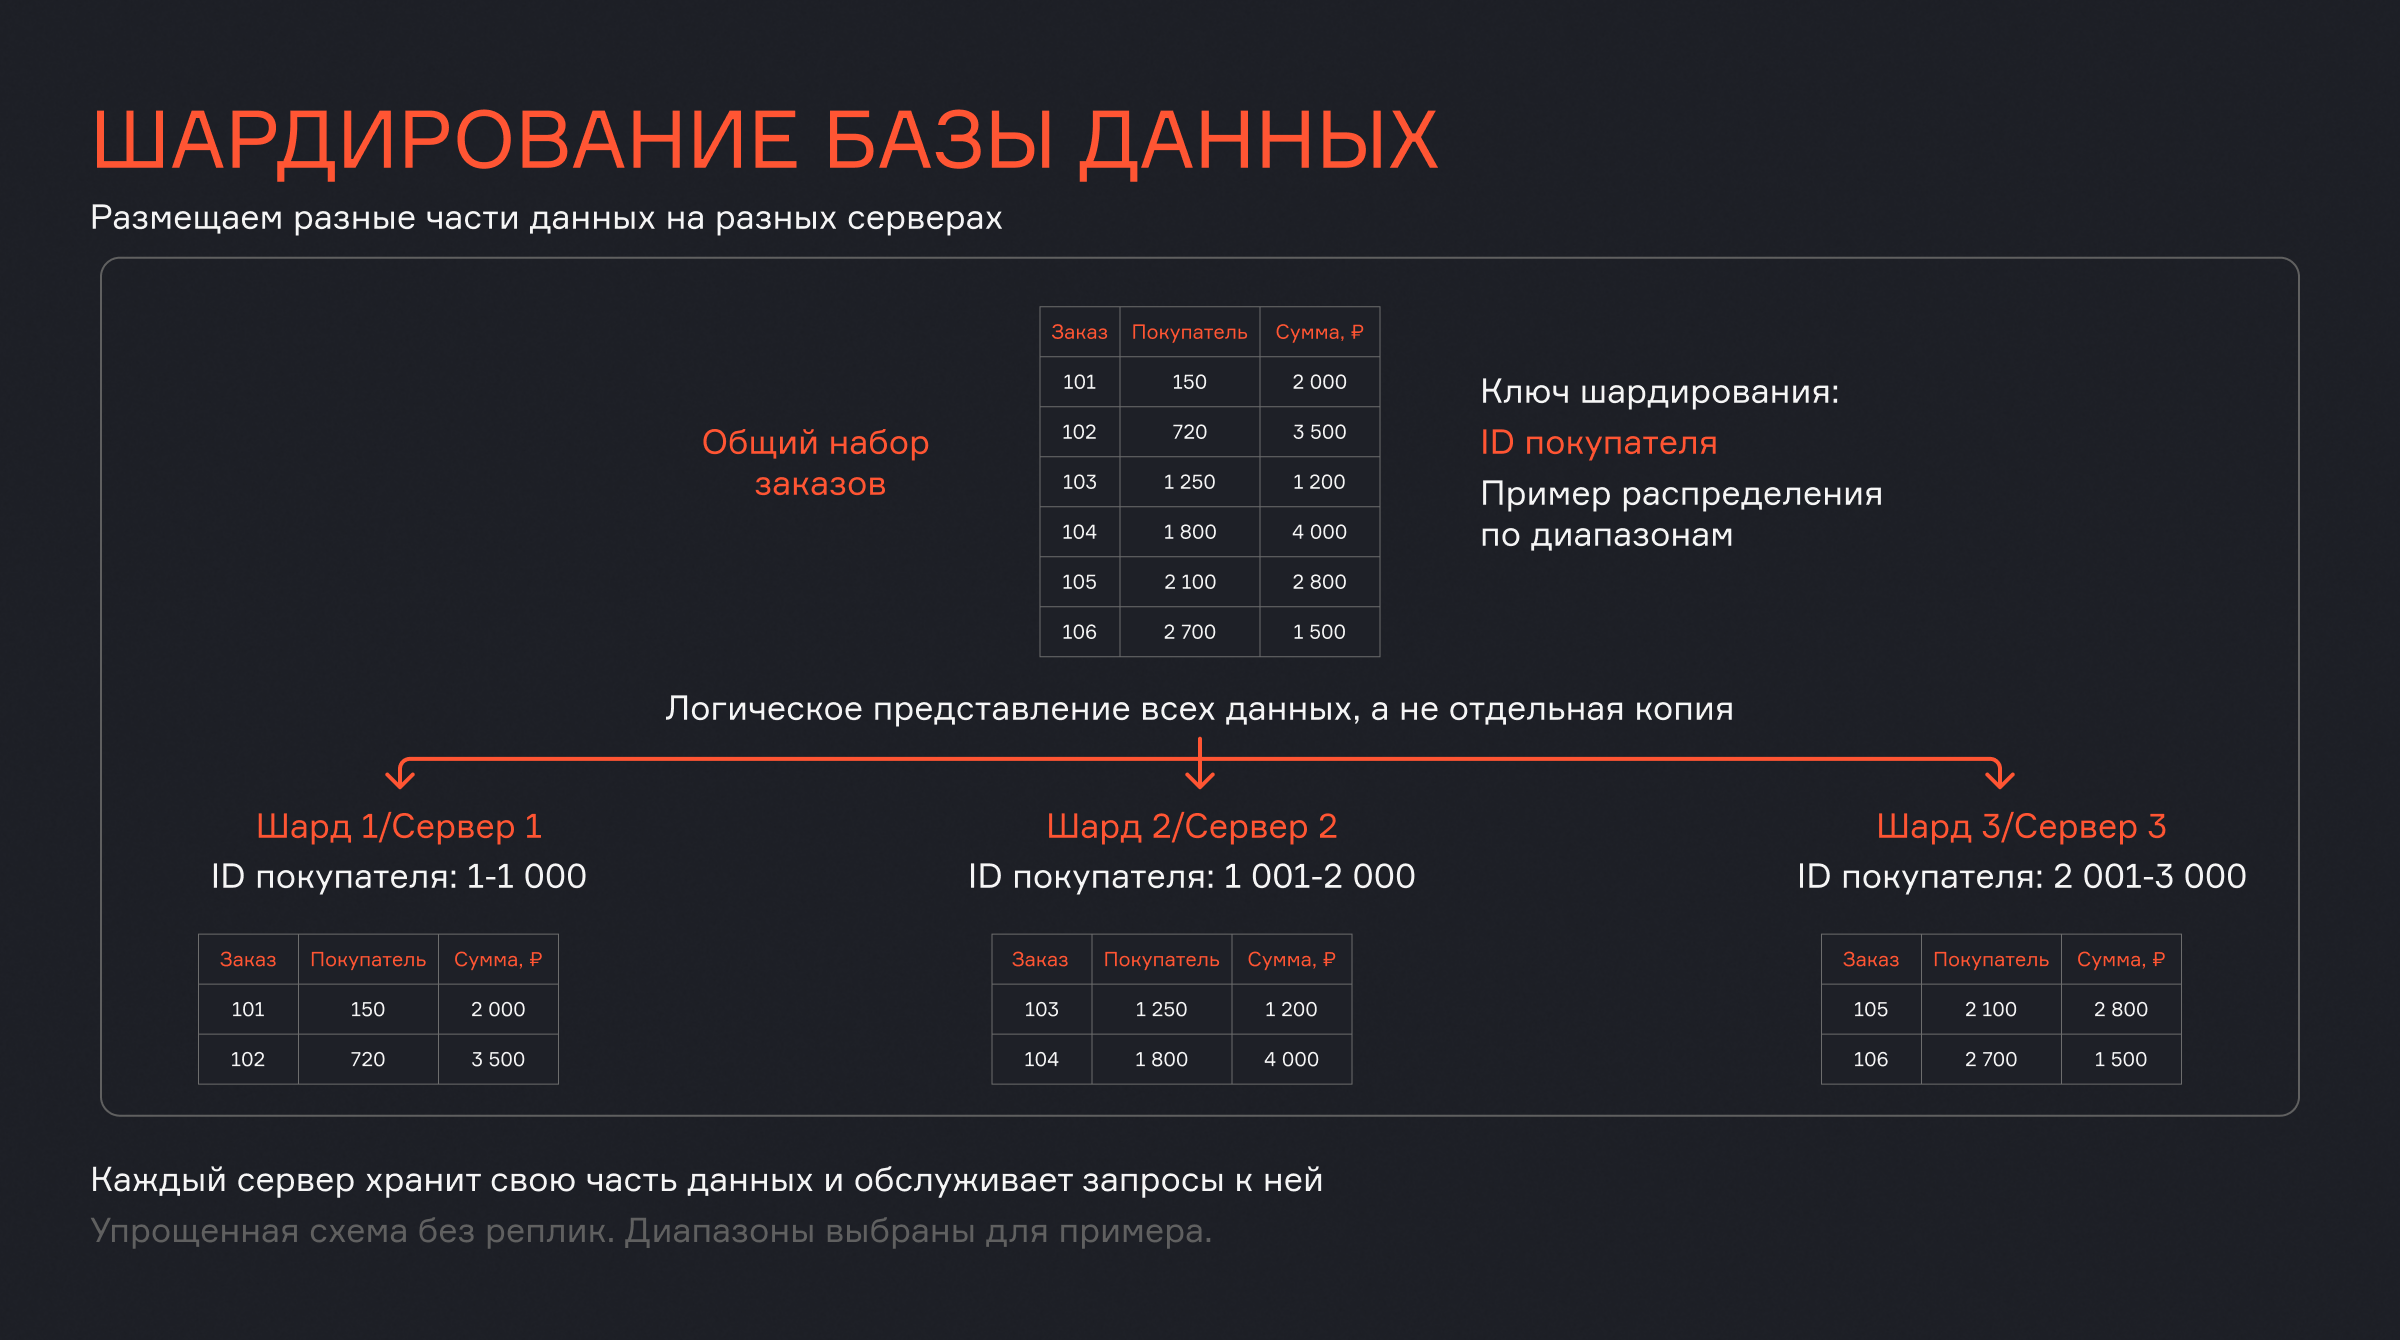
Что такое шардирование БД и зачем оно нужно
Шардирование данных — это разделение набора записей на части, которые можно размещать и обрабатывать на разных узлах. В магазине один шард может хранить заказы одной группы покупателей, другой — заказы другой группы. Каждый получает лишь часть общего потока операций.
Результат зависит от ключа — поля или набора полей, определяющих размещение. Если разделять заказы по покупателю, его историю можно получить из одного шарда. Но отчёт по всем покупателям потребует данных из нескольких мест.
Хороший ключ учитывает частые запросы, число различных значений и распределение нагрузки. Равное количество строк не гарантирует равной работы: один особенно активный клиент может перегрузить свой узел. Такой участок называют горячим шардом. Даже удачное хеширование не разделит операции над одним значением ключа.
Способы шардирования
- Диапазонное шардирование
Данные распределяют по диапазонам значений ключа. Например, заказы покупателей с ID от 1 до 1000 хранят на первом шарде, от 1001 до 2000 — на втором. Это удобно, когда нужно получить данные за определённый интервал: можно обратиться только к нужным узлам. Однако если идентификаторы растут последовательно, записи новых покупателей будут попадать в последний диапазон и могут перегрузить обслуживающий его сервер.
- Шардирование по хешу
Значение ключа, например ID покупателя, передают в хеш-функцию. Она вычисляет хеш (числовой результат преобразования исходного значения по определенному алгоритму), по которому система выбирает шард. Такой подход помогает равномернее распределить разные ключи между узлами. При этом соседние идентификаторы могут оказаться на разных серверах, поэтому для выборки по диапазону иногда приходится обращаться ко всем шардам.
- Каталожное шардирование
Система хранит отдельный справочник, в котором указано, на каком шарде находятся данные каждого покупателя или группы покупателей. Перед обращением к данным она проверяет этот справочник. Подход позволяет гибко менять размещение. Например, перенести данные крупного клиента на отдельный сервер и обновить запись в каталоге. Сам справочник должен оставаться доступным, а его изменения — учитываться всеми участниками системы.
Партицирование vs шардирование: в чём принципиальная разница
Шардирование и партиционирование БД позволяют разделить большой набор данных на части. При локальном партицировании эти части остаются внутри одной базы на одном сервере. Например, заказы разбивают по месяцам, чтобы быстрее находить нужный период и удобнее удалять старые данные. При шардировании части размещают на разных серверах, каждый из которых хранит и обрабатывает свою долю данных.
Главное отличие шардирования от партицирования — возможность использовать ресурсы нескольких машин. Разбив таблицу на месячные партиции, мы по-прежнему располагаем процессором, памятью и дисками одного сервера. Распределив заказы между серверами, получаем дополнительные ресурсы и можем разделить нагрузку между ними.
Маршрутизация запросов: как попасть в нужный шард
Нужную часть находит клиентская библиотека, маршрутизатор или компонент, который ещё и разбирает сложные запросы. Граница между последними вариантами зависит от системы.
Клиентский метод
Логику размещения знает приложение или используемый им драйвер. Получив идентификатор покупателя, оно вычисляет нужный шард и обращается прямо к нему. Дополнительный сетевой посредник не нужен, но клиенты должны согласованно обновлять карту размещения.
Прокси-сервер
Приложение обращается к общей точке входа, а прокси определяет нужное направление. Клиентам проще: им не нужно самостоятельно следить за расположением частей. Обновление маршрутов сосредоточено в одном слое. Его тоже нужно резервировать и проверять под нагрузкой.
Координатор: разделение запроса на подзадачи
Координатор способен разделить запрос на подзадачи, отправить их разным узлам и собрать ответ. Например, каждый шард вычисляет сумму продаж, а координатор складывает частичные результаты. Для среднего значения понадобятся и сумма, и количество: усреднять средние разных по размеру групп нельзя.
Сложнее обстоит дело с соединениями таблиц, глобальной сортировкой и транзакциями над несколькими частями. Горизонтальное масштабирование БД добавляет передачу данных по сети и дополнительное согласование. Глобальная уникальность значения тоже не всегда обеспечивается обычным локальным индексом.
Что делать при изменении числа шардов
Со временем места или производительности снова может не хватить. Добавить машину недостаточно: часть данных нужно передать ей вместе с нагрузкой. Перебалансировка меняет размещение частей, а решардинг может менять само разбиение, число шардов или ключ.
Проблема модульного хеширования
Один из простых способов выбрать шард — вычислить хеш ключа и разделить его на количество шардов. Остаток от деления станет номером нужного узла. Например, для трёх шардов возможны три результата: 0, 1 или 2. Пока количество узлов не меняется, система каждый раз направляет запросы с одним и тем же ключом по одному адресу.
Проблема возникает при добавлении сервера. Допустим, хеш ключа равен 15. При трёх шардах остаток от деления равен 0, поэтому запись хранится на шарде № 0. Если добавить четвёртый шард, остаток станет равен 3 — и то же правило уже укажет на шард № 3.
Сама запись при этом останется на прежнем месте. Чтобы запросы находили её по новому адресу, данные придётся перенести. Изменение числа шардов затронет множество ключей, поэтому добавление одного сервера может потребовать перераспределения значительной части данных.
Consistent Hashing: кольцо и виртуальные узлы
Диапазон значений представляют как кольцо с точками узлов и ключей. Владельцем ключа назначают следующий узел, например по часовой стрелке. После конца диапазона переходят к началу.
Добавленный узел забирает часть диапазона у соседа, остальные назначения сохраняются. Чтобы сгладить перекос, одному серверу назначают несколько виртуальных узлов — точек в разных местах кольца. Он получает множество небольших участков вместо одного большого.
Rendezvous Hashing: минимальные перестановки
Для ключа вычисляют оценку в паре с идентификатором каждого узла. Побеждает узел с наибольшей оценкой. При одинаковом списке участников и алгоритме клиенты получат одинаковый результат.
Если добавился новый узел, к нему переходят только ключи, для которых его оценка оказалась выше прежнего победителя. При удалении узла переназначаются ключи, которые принадлежали ему: побеждает следующий кандидат. В этом и состоит устойчивость размещения к изменению состава.
Виртуальные бакеты: дополнительный слой абстракции
Можно отвязать вычисление хеша от числа физических машин. Сначала ключ относят к одному из заранее заданных логических бакетов — например, 1024. Затем отдельная карта указывает, какой сервер обслуживает каждый бакет.
При добавлении машины переносят выбранные бакеты и обновляют карту. Ключ относится к прежнему бакету, меняется только владелец. Это позволяет переносить данные небольшими порциями.
Практические подходы к переносу данных
Проще всего остановить запись в переносимую часть, скопировать её, проверить результат и переключить обращения. Если допустимо окно обслуживания, это может быть надёжнее миграции на ходу.
Для работы с меньшим перерывом обычно сначала копируют исходное состояние и параллельно сохраняют последующие изменения. Затем целевой узел догоняет источник. Перед переключением нужно убедиться, что необходимые изменения применены, а новые записи не потеряются между двумя адресами.
Заранее продумывают откат. Если после переключения новые записи уже пошли на целевой узел, простого возврата старого адреса недостаточно: источник успел устареть. Нужен обратный поток изменений либо другой согласованный план восстановления. Конкретные системы, например Vitess, предоставляют инструменты управления такими этапами.
Как выбрать стратегию масштабирования: алгоритм принятия решений
Способы масштабирования БД сравнивают через решаемую задачу. Зафиксируйте требования, измерьте нагрузку, найдите ограничение и проверьте гипотезу на тесте. Затем оцените, оправдывает ли эффект сложность изменений.
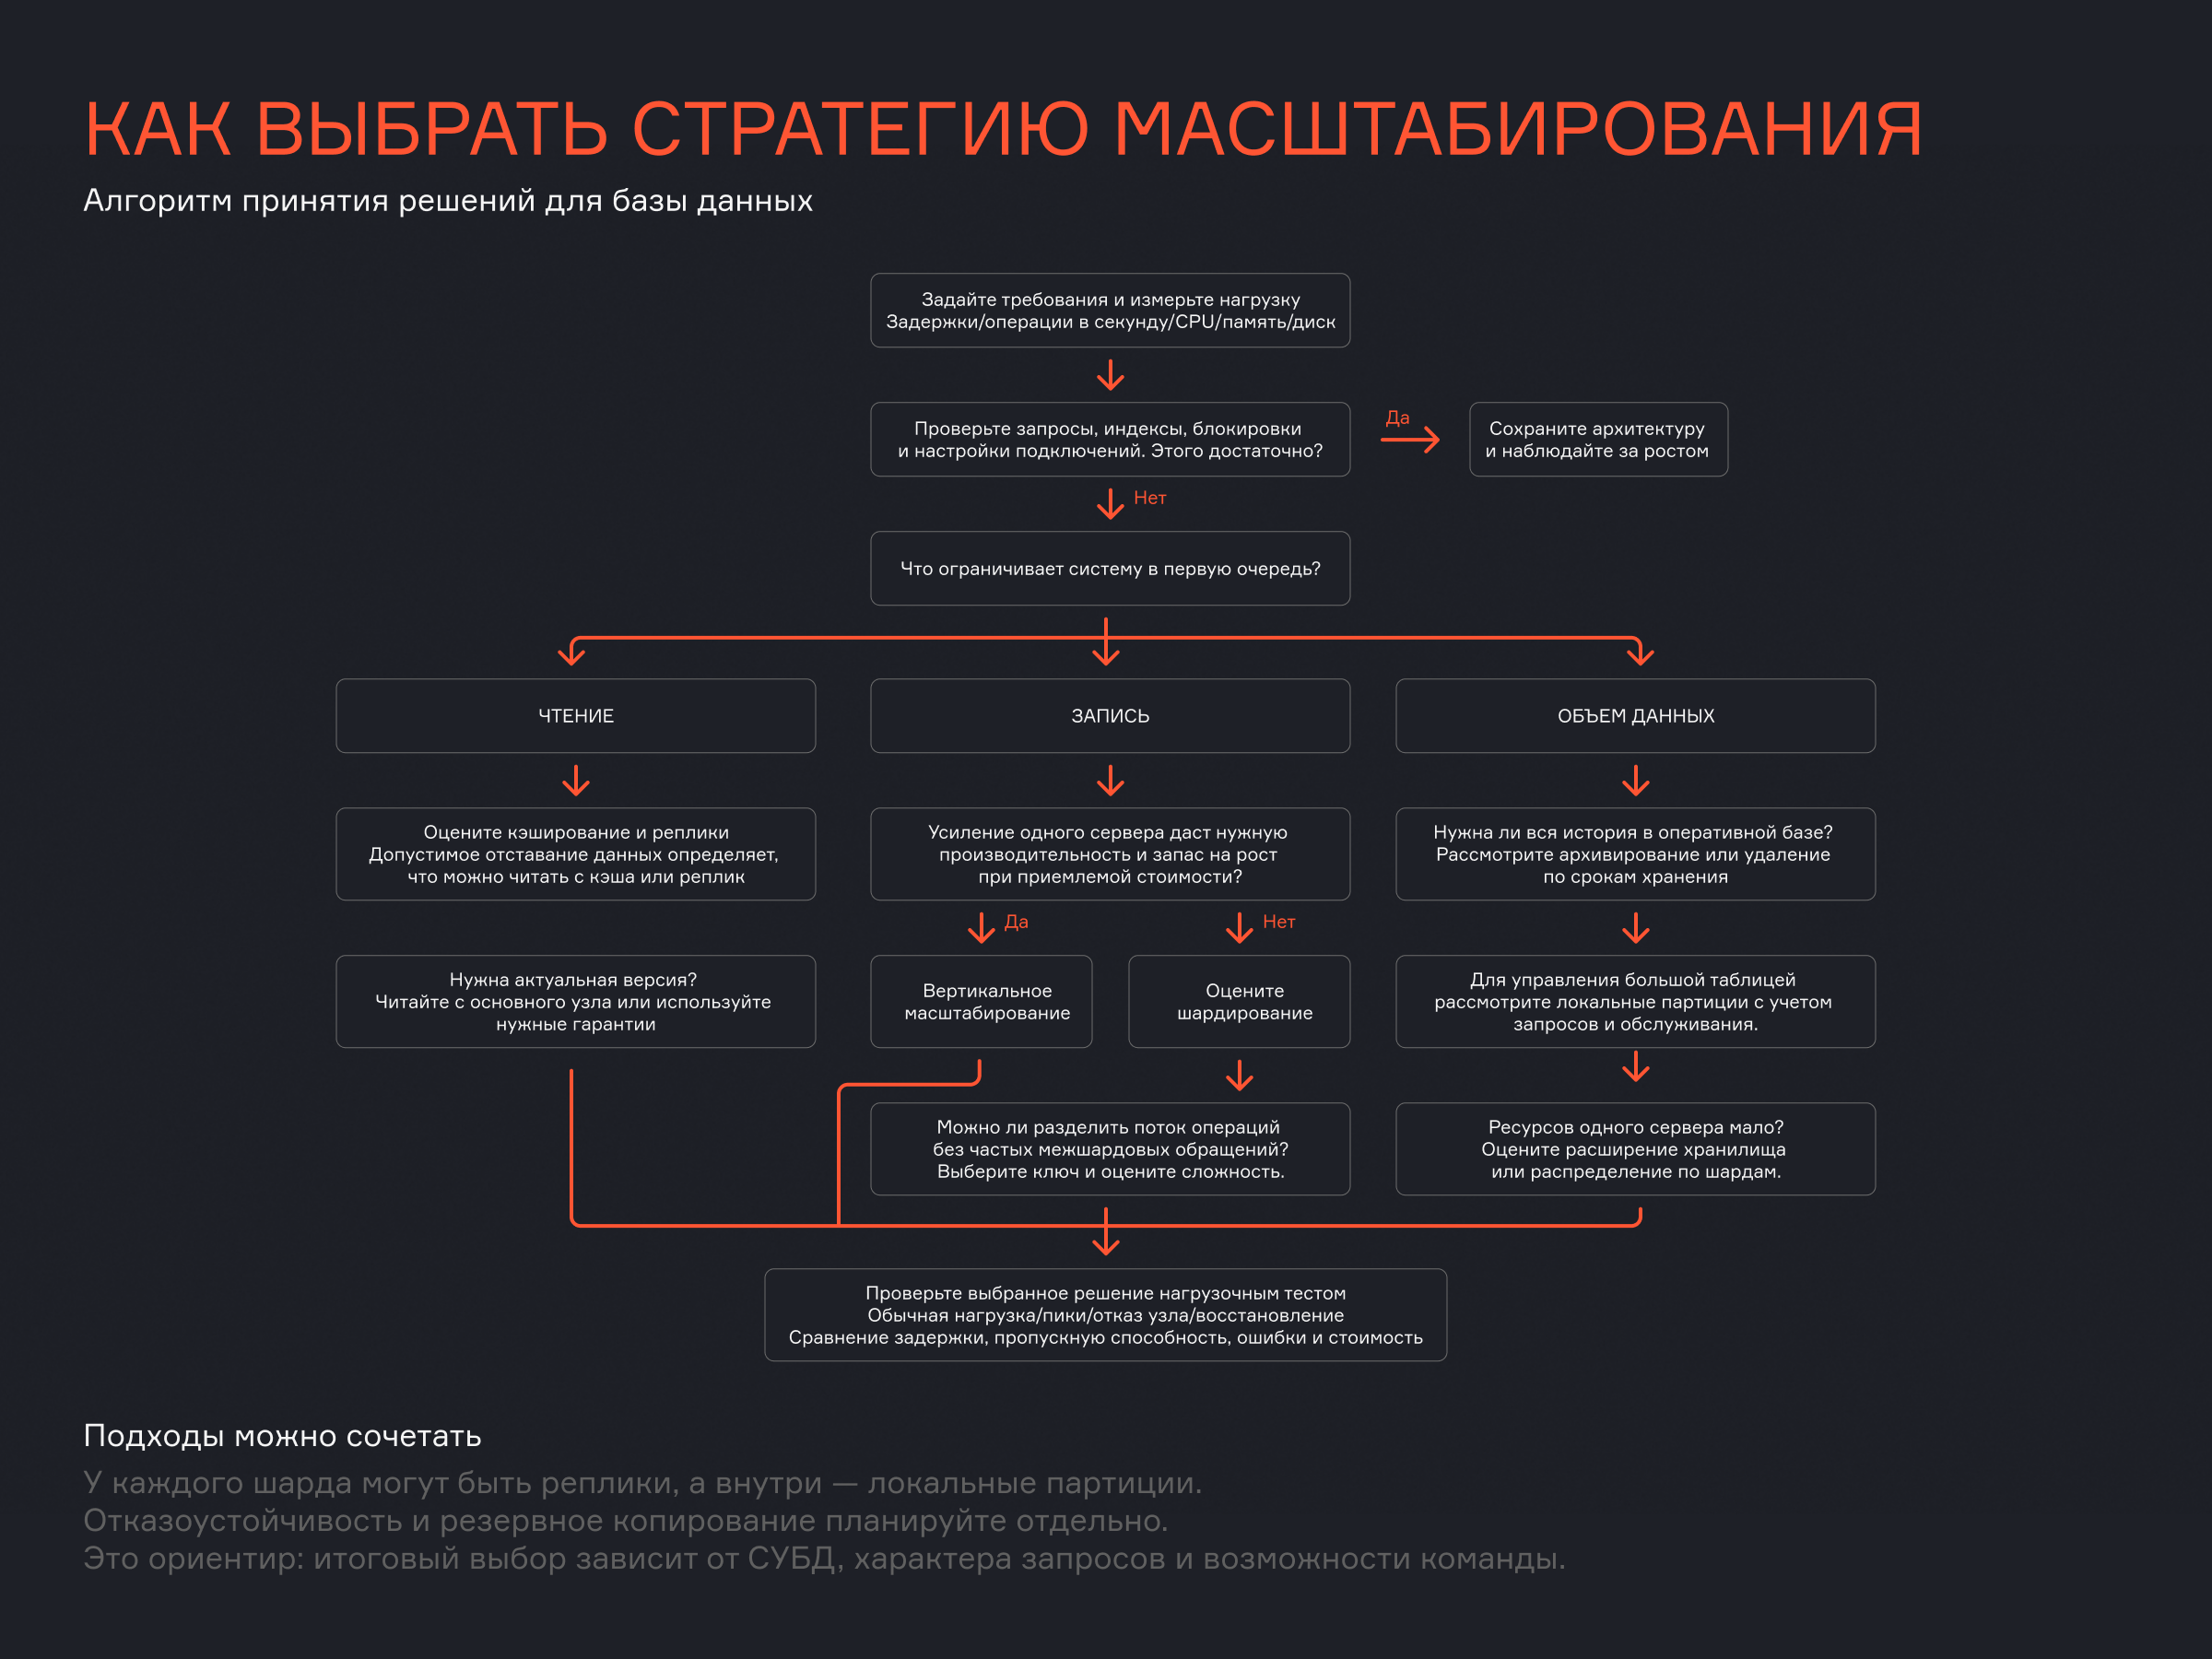
Что именно вы масштабируете: чтение, запись или объём данных
Если преобладает чтение, сначала проверьте запросы и индексы, затем оцените кэширование и читающие реплики. При этом выясните, допустимы ли устаревшие ответы. Каталог и подтверждение только что оформленного заказа могут требовать разного маршрута чтения.
При росте объема оцените архивирование старых данных, локальные партиции и распределенное хранение.
Если ограничивает запись, проверьте блокировки, длительность транзакций, скорость дисков и возможности основного узла. Когда одного сервера действительно мало, оцените разделение данных: удастся ли направить независимые операции в разные части без постоянного обмена между ними?
После изменения повторите измерения задержек, ошибок, пропускной способности и стоимости. Проверьте пики и отказ узла: результат должен соответствовать требованиям и в этих условиях.
Комбинирование подходов: репликация + шардирование
Эти механизмы дополняют друг друга. Допустим, заказы разделены на четыре шарда, и у каждого есть основной узел и читающая реплика. Разделение распределяет запись между четырьмя группами, а копии помогают обслуживать чтение и готовить резерв.
Так репликация и шардирование БД решают разные части задачи. При этом восемь машин не означают восьмикратный прирост производительности: есть накладные расходы, неравномерность нагрузки и обращения к нескольким частям. Резервам также нужно хватать ресурсов для работы после отказа.
Компромиссы CAP-теоремы на практике
При потере связи между частями распределенной системы нельзя одновременно гарантировать строгую согласованность и доступность всех операций. Это смысл CAP: выбор возникает при сетевом разделении, а не как постоянное правило «Возьмите любые два свойства из трёх».
Представим, что два узла потеряли связь, а покупатели пытаются заказать последний экземпляр товара. Если обе стороны независимо подтверждают покупку на основании старого остатка, возникает риск продать одну вещь дважды. Для сохранения согласованности часть операций придётся задержать или отклонить.
Масштабирование в контексте системного дизайна
Каталог, заказы, платежи и отчеты создают разную нагрузку. Выбор архитектуры требует понимания их связей, требований к данным и последствий отказов.
Почему это ключевой навык для архитектора и инженера
Архитектору и инженеру важно понимать, как система поведет себя при росте нагрузки: где возникнут ограничения, какие ресурсы понадобятся и сколько будет стоить их добавление. Это помогает выбирать решения с учётом задач продукта. Например, если медленно формируется отчет, который запускают раз в месяц, стоит оценить, нужно ли ради него менять всю архитектуру или достаточно оптимизировать сам запрос.
Как устроено обучение проектированию систем в крупных компаниях
Нет единой обязательной программы обучения архитектуре. Для подготовки к задачам и интервью такого уровня полезно практиковать полный разбор: от требований и оценки нагрузки до выбора компонентов и обсуждения компромиссов.
Такую последовательность предлагает курс «Системный дизайн». В программе — сбор требований, расчёт нагрузки, высокоуровневый дизайн, выбор баз данных, масштабирование, повышение отзывчивости и подсистемы поиска.
Обучение включает лекции, домашние задания, консультации с экспертами и финальный проект. В программе также разбирают проектирование интернет-магазина и сервиса такси. Курс ориентирован на специалистов среднего, ведущего и руководящего уровней и помогает готовиться к обсуждению архитектуры, в том числе на интервью в крупную технологическую компанию.
Заключение
Выбор начинается с конкретного ограничения: медленного чтения, перегруженной записи, растущего объёма или требований к доступности. Дополнительные ресурсы, копии и разделение данных дают разные результаты и требуют разной подготовки.
Одной системе достаточно усилить сервер, другой понадобятся реплики, третьей — распределение данных. Важно понимать причину каждого решения, проверять его эффект и уметь поддерживать систему после изменений.