Обработка данных в реальном времени: Kafka, RabbitMQ и потоковая аналитика
Kafka или RabbitMQ — что выбрать, если данные нужно обрабатывать по мере поступления? Обе технологии могут выполнять роль брокера сообщений: принимать данные от приложений, сохранять их и передавать получателям. Благодаря этому сервисам не обязательно работать с одинаковой скоростью и напрямую обращаться друг к другу при каждом событии.
Содержание
- Введение в мир потоковых данных
- Apache Kafka: распределенный лог для событийных потоков
- RabbitMQ: надежная очередь для распределения задач
- Kafka vs RabbitMQ: сравнительный анализ для выбора решения
- Проектирование распределенных систем: как не ошибиться с архитектурой
- Потоковая аналитика: превращаем поток данных в бизнес-инсайты
- Заключение
Причина сравнения понятна, ведь задачи пересекаются, а устройство различается. Kafka строится вокруг сохраняемого журнала событий, RabbitMQ в привычной модели — вокруг обменников и очередей. Эти различия влияют на повторную обработку данных, масштабирование и поведение при сбоях. Разберём их простыми словами и покажем, как связать выбор технологии с требованиями вашего проекта.
Введение в мир потоковых данных
Каждая покупка, просмотр товара или попытка оплаты создаёт новое событие. Такие события поступают непрерывно и складываются в поток данных. Прежде чем выбирать брокер для его передачи, нужно понять, как быстро бизнесу нужен результат обработки, какую нагрузку предстоит выдерживать и что может пойти не так.
Почему бизнесу нужна обработка данных в реальном времени
У информации есть срок годности. Вчерашний отчет помогает оценить результаты распродажи, но не позволяет исправить сломавшуюся оплату, пока покупатели уходят к конкурентам. Чтобы вмешаться вовремя, бизнесу нужна аналитика в реальном времени: показатели обновляются достаточно быстро для принятия конкретного решения.
Поток — это последовательность событий, которые продолжают поступать: товар просмотрели, заказ создали, платеж подтвердили. Приложение обрабатывает новые события по мере появления, не дожидаясь, пока накопится весь набор данных за день.
При этом «реальное время» не означает одинаковую скорость для всех. Для оперативного дашборда могут подойти десятки секунд, для обновления наличия — секунды. Эти значения нужно согласовать с бизнесом.
Системы обработки данных в реальном времени полезны, когда задержка влияет на результат: мешает вовремя обнаружить сбой, предложить товар или остановить подозрительную операцию. Если отчет читают раз в неделю, непрерывные вычисления могут лишь увеличить расходы.
Ключевые вызовы при работе с потоками
1. Задержка на всем пути от события до результата.
Быстрый брокер не поможет, если дашборд обновляется раз в час.
2. Неравномерная нагрузка.
Утром магазин принимает десятки заказов в минуту, вечером начинается акция и поток резко вырастает. Брокер может временно накопить сообщения, но запас диска и скорость обработчиков конечны. Если сведения постоянно приходят быстрее, чем обрабатываются, отставание будет расти.
3. Сбои.
Обработчик может сохранить покупку в базе и выключиться до того, как подтвердит завершение работы. После восстановления сообщение придет повторно. Без защиты магазин дважды учтет выручку или отправит два одинаковых письма.
Поэтому системы обработки потоковых данных проектируют с учетом повторов, опозданий и недоступности отдельных компонентов. Вопрос звучит не только как «сколько сообщений в секунду выдержим?», но и как «что произойдет, если один узел отключится в самый неподходящий момент?»
Apache Kafka: распределенный лог для событийных потоков
Событие об оплате заказа может понадобиться сразу нескольким сервисам: один обновит выручку, другой начислит бонусы, третий уточнит рекомендации. При этом каждый работает в своем темпе. Распределенный журнал позволяет сохранить события на нескольких серверах и дать каждому приложению возможность читать их независимо.
Архитектура Kafka: топики, партиции и офсеты
Журнал событий похож на общую тетрадь: одни приложения добавляют в нее записи, другие читают, сохраняя закладку на нужном месте. Прочитанное не исчезает только потому, что один получатель закончил работу: правила хранения задаются отдельно.
Приложения, которые отправляют события, называют производителями, или producers. Записи объединяют в топики — именованные потоки. Например, orders для заказов и payments для платежей.
Топик делится на партиции, каждая из которых хранит упорядоченную последовательность записей. Партиции распределяются между серверами — брокерами. Позиция записи внутри партиции называется офсетом. Сохраняя позицию чтения, приложение может продолжить работу после перезапуска.
Порядок записей сохраняется внутри партиции, а не во всём топике. Если изменения одного заказа должны идти последовательно, его идентификатор используют как ключ маршрутизации. Пока схема распределения не меняется, такой ключ направляет связанные события в одну партицию.
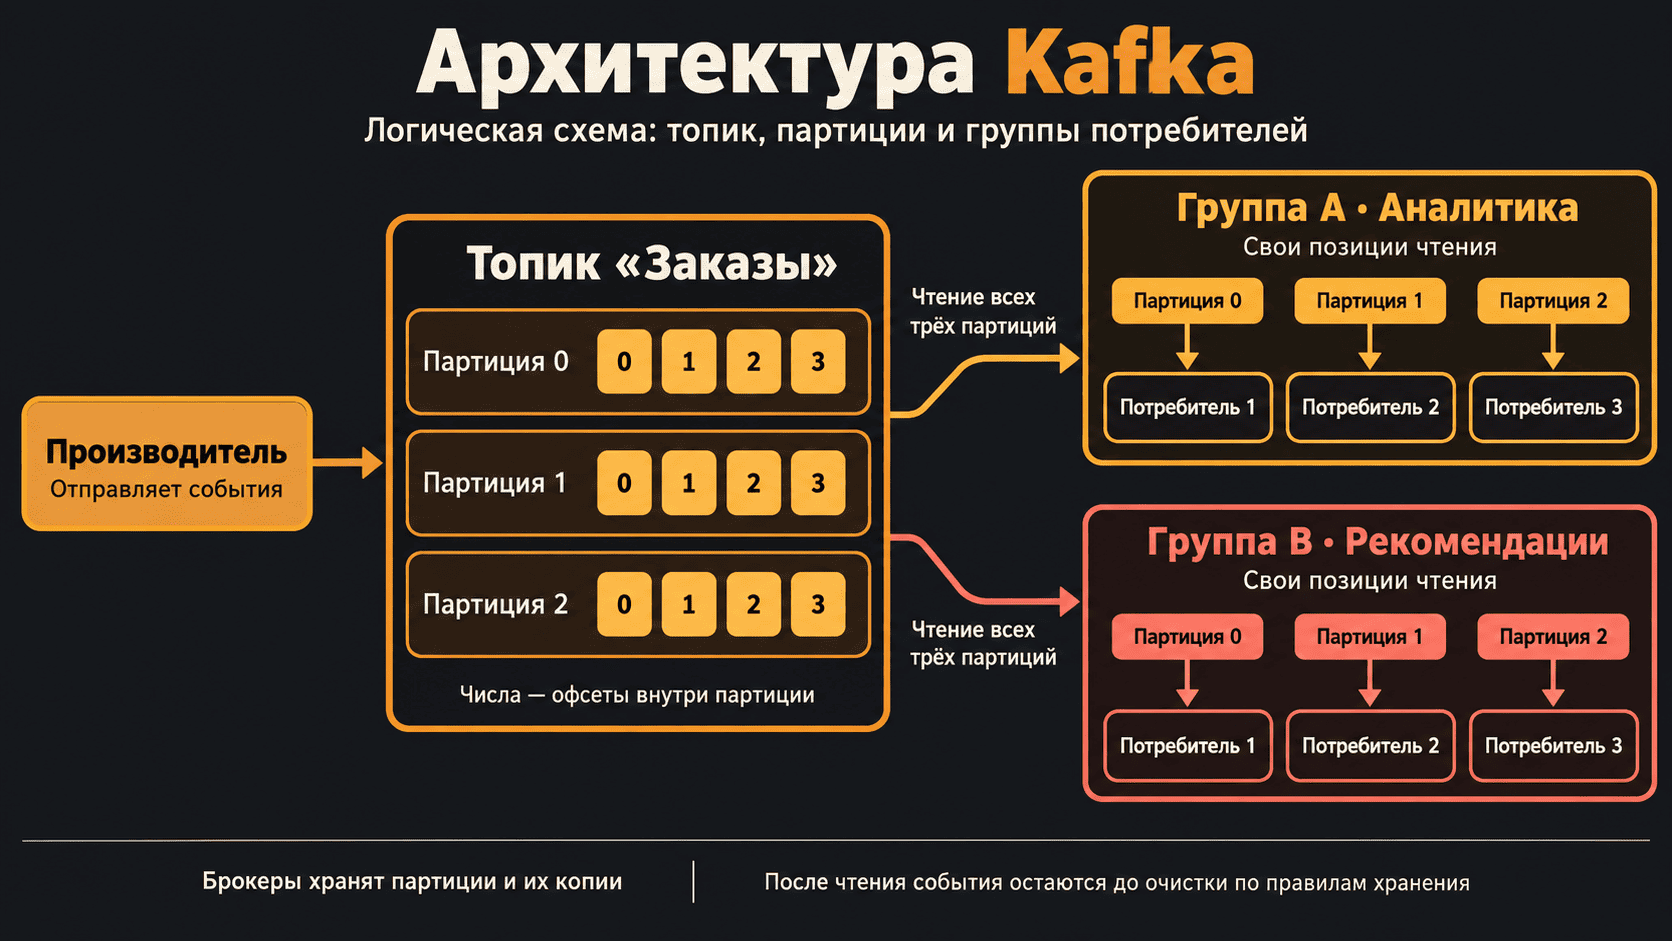
Для защиты от сбоев партиции реплицируют, т.е. создают их копии на нескольких брокерах. У каждой партиции есть ведущая копия — лидер, а остальные поддерживают копии данных. Это помогает пережить отказ сервера, но результат зависит от настроек записи, состояния копий и характера сбоя. Поэтому заранее нужно продумать, как система будет восстанавливаться.
Модель потребления
Приложения, которые читают события, называют потребителями, или consumers. Если несколько экземпляров приложения совместно выполняют одну задачу, их объединяют в consumer group — группу потребителей. В стандартной групповой модели каждая партиция в конкретный момент назначена одному участнику группы.
Предположим, у топика с заказами шесть партиций, а у сервиса расчёта выручки три экземпляра. При равномерном распределении каждому достанется по две партиции. Если экземпляров станет шесть, каждый сможет читать свою. Седьмой не ускорит чтение этого топика в той же группе: свободных партиций для него не останется.
Для других задач создают отдельные группы. Например, сервис рекомендаций читает события о заказах независимо от сервиса расчета выручки. У каждого свой прогресс: если рекомендации отстали, аналитика может продолжать работу.
Платформа также поддерживает share groups — группы с другой моделью совместной обработки и подтверждением отдельных записей. Этот механизм расширяет возможности работы с очередями задач. Его доступность и настройки нужно проверять для выбранной версии и клиентских библиотек.
Когда Kafka — это правильный выбор
Платформу стоит рассмотреть, когда события нужны нескольким независимым получателям и должны оставаться доступными для повторного чтения. Например, интернет-магазин использует историю покупок одновременно для отчетов, рекомендаций, контроля подозрительных действий и передачи данных в хранилище.
При использовании Apache Kafka потоковая обработка данных обычно требует дополнительных компонентов. Сам брокер хранит и передаёт записи. Показатели рассчитывают приложения, встроенная в экосистему библиотека потоковой обработки или отдельный движок, например Flink. Поэтому установка брокера — лишь один из шагов к работающему аналитическому пайплайну (сценарию).
Kafka для аналитика становится возможностью лучше понять путь данных от покупки до отчёта. Для этого не обязательно администрировать серверы. Достаточно разобраться, почему свежие продажи появляются с задержкой, откуда берутся повторы и когда можно пересчитать историю. Эти знания помогают задавать инженерам точные вопросы и правильно интерпретировать метрики.
Ограничения
- История хранится по заданным правилам.
Удаление по сроку или объёму ограничивает доступный набор событий. Другой механизм — компактация — помогает сохранять последние значения по ключам, но не заменяет полный архив изменений. Перед повторным расчётом важно убедиться, что нужные записи ещё доступны.
- Надёжность зависит от согласованных настроек.
Параметр acks определяет, каких подтверждений ждёт отправитель. Настройка минимального числа синхронных копий влияет на возможность продолжать запись при сбоях. Идемпотентный отправитель помогает избежать части дублей при повторной отправке. Эти механизмы нужно настраивать вместе.
- Не все действия защищены от повторов.
Транзакции позволяют согласовать сохранение позиции чтения и запись результатов в другие топики. Но внешний платёж или отправка письма автоматически в такую транзакцию не входят. Для этих действий нужна отдельная защита: повторно полученное событие не должно приводить к повторному списанию денег или второму письму.
RabbitMQ: надежная очередь для распределения задач
Отправить уведомление, сформировать документ, обработать фотографию — такие задачи можно передать отдельным исполнителям. Брокер распределяет сообщения по очередям, из которых приложения получают работу. Это позволяет выполнять задачи в фоне: например, покупатель может продолжить покупки, пока сервис готовит запрошенный отчёт.
Архитектура RabbitMQ
Рассмотрим привычную модель очередей с протоколом AMQP 0-9-1 — набором правил, по которым приложения обмениваются сообщениями с брокером.
Отправитель публикует сообщение в exchange, или обменник. Тот определяет, куда его направить, и передаёт в подходящие queues — очереди. Связи между обменником и очередями называются bindings, или привязками. При выборе маршрута может использоваться routing key — ключ маршрутизации, например order.paid для оплаченного заказа.
У обменников есть несколько типов:
- Direct направляет сообщение в очереди, у которых ключ привязки точно совпадает с ключом сообщения.
- Topic сопоставляет ключ с шаблонами. Например, order.* подходит для order.paid и order.created.
- Fanout рассылает сообщение во все привязанные очереди.
- Headers выбирает очереди по значениям заголовков — дополнительных полей сообщения.
Здесь важно не путать topic exchange с топиком распределенного журнала из предыдущего раздела. Обменник определяет маршрут сообщения, а топик служит для хранения потока событий.
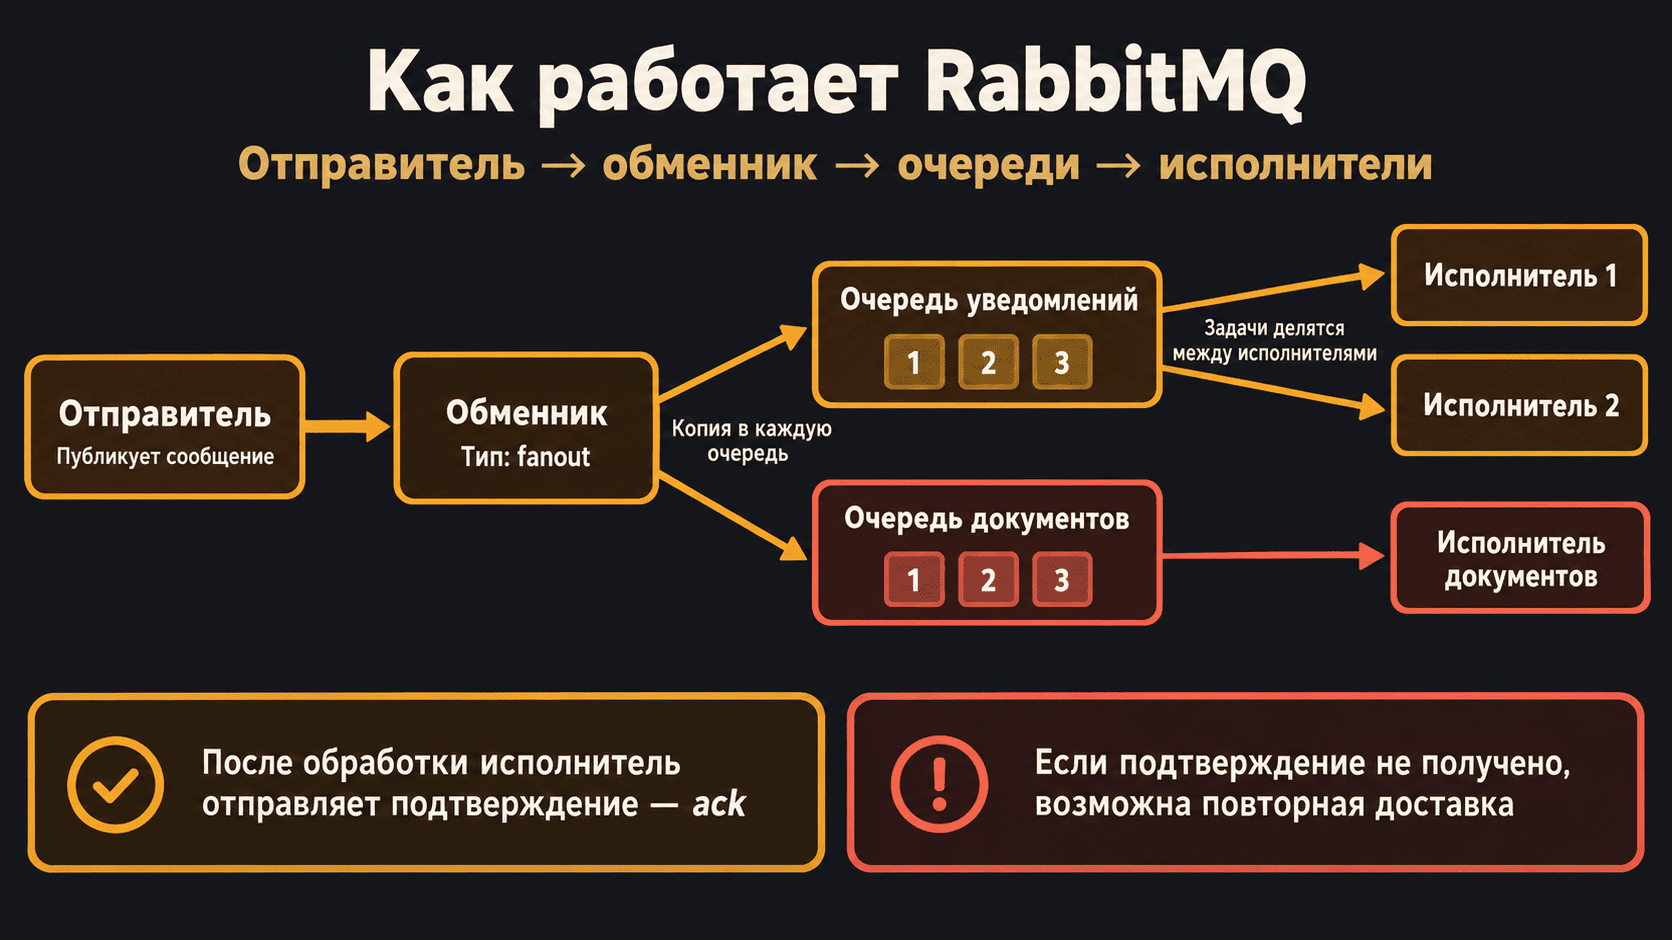
В интернет-магазине событие об оплате можно направить в две очереди: для уведомлений и подготовки документов. Каждый сервис получит свою копию. Если же к одной очереди подключить несколько исполнителей, они будут делить поступающие задачи между собой.
Модель доставки
В типичном сценарии используется модель push: приложение подписывается на очередь, и брокер отправляет ему сообщения. Получать их отдельными запросами тоже можно, но для постоянной обработки обычно выбирают подписку. При модели pull, знакомой нам по распределенному журналу, потребитель сам запрашивает записи.
Чтобы исполнитель не получил слишком много работы сразу, используют параметр prefetch. Он ограничивает число сообщений, которые можно получить без подтверждения обработки. Слишком большое значение может привести к накоплению задач у отдельных исполнителей, а слишком маленькое — заставить их простаивать в ожидании следующего сообщения.
Чтобы понять, как работать с RabbitMQ, важно различать два вида подтверждений:
- Publisher confirms — брокер подтверждает отправителю, что принял публикацию. Это ещё не означает, что исполнитель выполнил задачу.
- Consumer acknowledgement, или ack, — исполнитель сообщает брокеру, что обработал доставленное сообщение.
При ручном подтверждении ack обычно отправляют после успешной обработки. Если соединение оборвалось раньше, сообщение может вернуться в очередь и поступить исполнителю повторно. При этом действие уже могло завершиться: например, письмо отправлено, а подтверждение не дошло. Поэтому приложениям нужна защита от повторного выполнения.
Для устойчивости к отказам серверов используют quorum queues — очереди с копиями на нескольких узлах. Для их работы должно быть доступно большинство копий. Объявление очереди как durable, то есть сохраняемой после перезапуска брокера, само по себе не создает таких копий.
Ключевые сценарии использования RabbitMQ
Эту платформу выбирают для задач с понятным результатом: сформировать документ, обработать изображение, отправить уведомление или проверить файл. Приложение передает поручение в очередь, а один из исполнителей — рабочих процессов, или workers, — получает его и выполняет.
Например, покупатель запросил историю заказов в PDF. Сайт сообщает, что документ готовится, и ставит задание в очередь. Обработчик создает файл, сохраняет его и отправляет пользователю ссылку. Держать страницу открытой до завершения операции не нужно.
Возможности платформы при этом не ограничиваются обычными очередями. Механизм Streams позволяет хранить журнал сообщений и читать их повторно, а super streams — разделять поток на части для масштабирования. Поэтому потоковые сценарии тоже возможны, но их нужно рассматривать отдельно от описанной модели очередей.
Встроенные возможности
TTL, или время жизни, задаёт, сколько сообщение может оставаться в очереди до истечения срока. Например, уведомление о короткой акции бесполезно доставлять после её завершения. Этот механизм помогает не выдавать просроченные сообщения, но не останавливает уже начавшуюся обработку. Поэтому исполнитель тоже должен проверять, актуальна ли задача.
Dead Letter Queue, или DLQ, — отдельная очередь для сообщений, выведенных из обычного процесса обработки. Перенаправление настраивают через специальный обменник — dead letter exchange. Туда могут попасть, например, сообщения с истекшим сроком жизни или сообщения, которые исполнитель отклонил без возврата в исходную очередь. Так их можно сохранить для разбора причин и решения, что делать дальше.
Приоритеты позволяют выдавать более важные сообщения раньше остальных. Однако они не прерывают уже начатую задачу и могут увеличивать ожидание менее срочных сообщений. Возможности и настройки зависят от типа очереди и версии брокера. Иногда проще создать отдельные очереди для срочных и обычных задач и выделить каждой своих исполнителей.
Kafka vs RabbitMQ: сравнительный анализ для выбора решения
Основное отличие Kafka от RabbitMQ в распространенных сценариях — в способе организации работы с сообщениями. Первое часто выбирают как сохраняемый поток для независимых читателей. Очереди второго — как механизм маршрутизации и передачи работы исполнителям.
Сравнение по ключевым критериям
| Критерий | Kafka | RabbitMQ |
| Основная модель | Журнал записей, разделенный на партиции | Маршрутизация в очереди и выдача исполнителям |
| После успешного чтения | Запись остается до очистки по политике хранения | Подтвержденное сообщение удаляется из очереди |
| Повторная обработка истории | Чтение с нужных офсетов, пока данные сохранены | Нужен отдельный архив или другая модель хранения |
| Независимые приложения | Разные consumer groups | Отдельные очереди с нужными привязками |
| Параллелизм | Для стандартной группы связан с числом партиций | Несколько потребителей очереди; далее распределение по очередям |
| Порядок | Внутри партиции; обработчик должен его учитывать | Зависит от потребителей, повторов и приоритетов |
| Подтверждение прогресса | Сохранение позиции чтения | Подтверждение конкретной доставки |
| Маршрутизация | Топики, ключи и логика приложений | Обменники и правила привязки |
| Типичная задача | История событий и независимые потоки обработки | Фоновые задания и доставка сообщений сервисам |
Если сравнивать Kafka и RabbitMQ, разница не сводится к формуле «одна быстрее, другая надежнее». Обе системы можно настроить удачно или неудачно. Производительность зависит от размера сообщений, репликации, накопления пачек, дисков, сети и работы потребителей.
Как сделать выбор: чек-лист для архитектора
Начните с вопросов о данных и работе приложений:
1. Что передаем — факт или поручение?
Событие о покупке может понадобиться многим. Заданию сформировать файл обычно нужен один исполнитель.
2. Нужна ли история?
Возможность подключить нового читателя и пересчитать прошлый период — сильный аргумент в пользу сохраняемого потока.
3. Кто читает данные?
Независимые приложения должны получать сообщения отдельно; дополнительные экземпляры одного сервиса обычно делят работу.
4. Где важен порядок?
Для каждого заказа, пользователя или всего потока? Чем шире требование, тем труднее распараллелить обработку.
5. Как переживаем сбои?
Определите допустимые потери, длительность простоя и способ устранения повторов.
6. Какие правила доставки нужны?
Приоритеты, истечение срока, сложная маршрутизация и повторы отдельных задач влияют на выбор модели.
7. Кто будет поддерживать систему?
Учитывайте навыки команды, мониторинг, стоимость инфраструктуры и обновления.
Можно ли использовать их вместе
Да, если у компонентов разные роли. Например, сервис читает из Kafka событие об оплате и публикует в RabbitMQ команду сформировать документ. Здесь появляется уязвимое место: две системы не образуют автоматически общую транзакцию. Если подтвердить чтение раньше публикации, команду можно потерять. Если опубликовать раньше подтверждения, при сбое возможен повтор.
Значит, переход между системами требует устойчивого протокола, повторных попыток и защиты исполнителя от дублей. Это отдельная инженерная задача, которую нельзя спрятать за стрелкой на архитектурной схеме.
Проектирование распределенных систем: как не ошибиться с архитектурой
Выбрать брокер — только часть работы. Нужно также решить, как сервисы будут обмениваться данными, справляться с ростом нагрузки и восстанавливаться после сбоев. Ошибки на этом уровне могут привести к потерянным заказам, повторным списаниям и задержкам, даже если сам брокер работает исправно.
Такие вопросы решает системный дизайн (System Design) — проектирование программных систем с учетом их задач и ограничений. По мере роста разработчика от него всё чаще ждут умения принимать и объяснять архитектурные решения. Этот навык помогает брать на себя более сложные проекты и готовиться к интервью, которые проводят многие крупные технологические компании при найме инженеров и технических руководителей.
Чтобы системно подготовиться к таким задачам и собеседованиям, мы создали курс «Системный дизайн». Он помогает выстроить целостный подход к проектированию масштабируемых систем и аргументировать свои решения. Ниже разберем несколько вопросов, с которых начинается такая работа: типичные ошибки, требования к производительности и способы организации взаимодействия сервисов.
Типичные ошибки при выборе брокера сообщений
Не защищаться от повторов. Например, обработчик использует уникальный ID операции, а база запрещает вторую запись с тем же идентификатором. Проверку и изменение результата нужно согласовать атомарно: простого «сначала посмотрим, затем запишем» недостаточно при конкурирующих процессах.
Записывать заказ и публиковать событие независимо. База может успешно сохранить заказ, но отправка в брокер — завершиться ошибкой. Один из способов устранить этот разрыв — transactional outbox: запись о заказе и будущей публикации сохраняются в одной транзакции базы, затем отдельный процесс отправляет событие. Повторы публикации все равно нужно учитывать.
Забывать о формате сообщений. Если сервис переименовал поле суммы, старый потребитель может перестать работать. Для событий нужен контракт: обязательные поля, типы, единицы измерения, смысл даты и правила совместимых изменений. У суммы без валюты и указания, рубли это или копейки, слишком много трактовок.
Как учитывать требования к задержкам, throughput и надежности
Требование «быстро» нужно превратить в измеримую цель. Например: «99% оплаченных заказов появляются в оперативной витрине не позднее чем через 10 секунд».
- Latency — время прохождения одного события.
- Throughput — объем, который система обрабатывает за единицу времени.
Они связаны, но не взаимозаменяемы. Обработка большими пачками может улучшить пропускную способность и одновременно добавить ожидание отдельных записей.
Предположим, обработчики остановились на пять минут при потоке тысяча сообщений в секунду. Накопится 300 тысяч сообщений. Если после запуска они обрабатывают 1500 в секунду, а тысяча новых продолжает поступать, запас разгребается со скоростью 500 сообщений в секунду. Восстановление займет еще около десяти минут при неизменной нагрузке.
Архитектурные паттерны
Event-driven, или событийная архитектура, означает, что компоненты реагируют на факты. Сервис заказов публикует «Заказ оплачен», а другие приложения сами решают, что делать: обновить витрину, начислить бонусы, подготовить документы. Отправителю не нужно знать каждую последующую операцию.
CQRS разделяет модели изменения и чтения данных. Рабочая система хранит заказ так, как удобно проводить операции, а аналитическая витрина — так, как удобно отвечать на вопросы. События могут обновлять витрину продаж по минутам, категориям и регионам. Сам по себе CQRS не требует ни Kafka, ни RabbitMQ, ни полного хранения истории событий.
Микросервисы используют брокер для асинхронного взаимодействия, но очередь не устраняет все зависимости. Если оформление заказа немедленно ждет ответа пяти сервисов, система остается чувствительной к их задержкам. Нужно решить, какие операции действительно обязаны завершаться сразу, а какие могут выполняться позже.
Потоковая аналитика: превращаем поток данных в бизнес-инсайты
Рабочая платформа аналитики данных включает больше, чем брокер. Обработка больших данных в реальном времени требует согласованной работы всего контура. У нее есть источники событий, транспорт, обработчики, хранилище результатов и интерфейс для пользователей. На каждом этапе можно потерять скорость, точность или понятность показателей.
Из чего состоит пайплайн аналитики реального времени
На базе Kafka потоковая обработка данных может выглядеть так: события заказов поступают в топик, вычислительное приложение считает продажи за минуту, результат попадает в аналитическую базу. Брокер в этой схеме обеспечивает движение и хранение событий; формулу выручки задает приложение.
Потоковые движки используют временные окна и watermarks — отметки продвижения по времени событий. Они помогают решить, когда пора выпускать результат окна и как учитывать опоздания. Это не гарантия, что более старые события уже никогда не придут: политику поздних данных задают отдельно.
Поэтому потоковая обработка и анализ данных требуют договоренности о точности. Можно быстро показать предварительную сумму, затем скорректировать ее при поступлении опоздавших событий. Или подождать дольше ради более полного результата. Универсально правильного интервала ожидания нет.
Пакетная vs потоковая обработка: где и что лучше
Первая естественна для периодических расчетов, вторая — для оперативной реакции.
| Задача | Подход | Почему |
| Годовой отчет по продажам | Пакетный | Важна полнота периода, а не обновление каждую секунду |
| Обнаружение всплеска ошибок оплаты | Потоковый | Ценность результата быстро уменьшается с задержкой |
| Пересчет истории после изменения формулы | Пакетный или повторное чтение потока | Нужно обработать уже накопленные данные |
| Контроль текущей распродажи | Потоковый | Команда принимает решения во время акции |
| Финальная сверка оперативных показателей | Периодический пакетный | Можно учесть опоздания, исправления и расхождения |
Потоковая обработка данных в режиме реального времени не отменяет пакетную. Магазин может обновлять оперативные показатели постоянно, а ночью сверять их с подтвержденными операциями. Такая схема полезна, если у двух расчетов согласованы определения метрик.
Типичный пайплайн: от данных до дашборда
Соберем пример для интернет-магазина. Задача — видеть число оплаченных заказов, сумму продаж и долю ошибок оплаты с небольшой задержкой. Под выручкой для этой оперативной витрины договоримся понимать сумму подтвержденных оплат за вычетом подтвержденных возвратов.
Шаг 1. Определяем события. У каждой оплаты и каждого возврата есть уникальный идентификатор операции, ID заказа, сумма, валюта и время совершения. Ошибки оплаты передаются отдельно. Если магазин работает с разными валютами, их нельзя просто складывать: потребуется явное правило пересчета.
Шаг 2. Обеспечиваем публикацию. Сервис сохраняет изменения заказа и запись outbox в одной транзакции. Процесс доставки переносит события в Kafka. По идентификатору заказа связанные изменения направляются в согласованный поток обработки.
Шаг 3. Проверяем и обогащаем. Обработчик проверяет обязательные поля, распознает повтор операции, добавляет категорию товара и регион. Некорректные записи уходят в отдельный поток разбора, а не исчезают незаметно. Для исторического анализа важно решить, брать категорию на дату покупки или ее текущее значение.
Шаг 4. Считаем показатели. Приложение собирает минутные интервалы, учитывает допустимые опоздания и корректировки. Возврат становится отдельной операцией с понятным влиянием на показатель. Нужно заранее определить, уменьшает ли он продажи дня возврата или пересчитывает период исходной покупки.
Шаг 5. Сохраняем результат. Агрегаты попадают в аналитическое хранилище. Запись должна учитывать повторные попытки: повторная отправка результата за ту же минуту не должна удвоить сумму. Конкретный механизм зависит от выбранной базы и способа обновления витрины.
Шаг 6. Показываем свежесть. Дашборд отображает не только цифры, но и время актуальности данных. Если поток отстал, пользователь должен увидеть предупреждение. Иначе падение линии продаж легко принять за реальное снижение спроса, хотя причина — остановившийся обработчик.
Заключение
Начните выбор брокера с требований: какие данные передаете, нужна ли история, сколько можно ждать, где важен порядок и как система должна вести себя при сбое. Затем проверьте решение на своей нагрузке — вместе с отказами и восстановлением.
Kafka и RabbitMQ решают пересекающиеся задачи, но предлагают разные удобные отправные точки. Kafka подходит для сохраняемых событийных потоков, независимых читателей и повторных расчетов. Очереди RabbitMQ — для маршрутизации сообщений и распределения работы между исполнителями. Дополнительные механизмы обеих платформ расширяют эти сценарии.