Метрики ранжирования: что такое NDCG, MAP и почему они важнее точности (accuracy)
«Модель правильно оценивает 95% документов» — звучит убедительно. Но что означает правильно? Модель отличает подходящие документы от неподходящих? Ставит лучший ответ первым? Помогает найти нужное на первой странице?
Содержание
- Почему accuracy не подходит для оценки ранжирования
- Что такое метрики ранжирования и зачем они нужны
- MAP (Mean Average Precision) — метрика, которая учитывает порядок
- NDCG (Normalized Discounted Cumulative Gain) — метрика для многоуровневой релевантности
- MAP или NDCG: что и когда использовать
- Другие метрики ранжирования
- Как оценивать ранжирование на практике
- Продвинутый уровень: когда метрик становится больше, а задача — сложнее
- Заключение
Можно верно определить большинство нерелевантных документов, но спрятать полезные внизу выдачи. Доля правильных ответов останется высокой, а пользоваться поиском будет неудобно.
Разберем, как устроена оценка качества ранжирования, что измеряют MAP и NDCG и как выбрать метрику. Примером будет поиск учебных материалов по запросу «оконные функции SQL».
Почему accuracy не подходит для оценки ранжирования
В классификации модель присваивает объекту класс. В ранжировании — определяет его место среди других объектов. Если оценивать обе задачи одинаково, можно не заметить ошибки, которые влияют на результат поиска.
Что измеряет accuracy и в чём её ограничения
Accuracy — метрика классификации, которая показывает долю правильных предсказаний. Для задачи с одним классом на объект формула accuracy выглядит так:
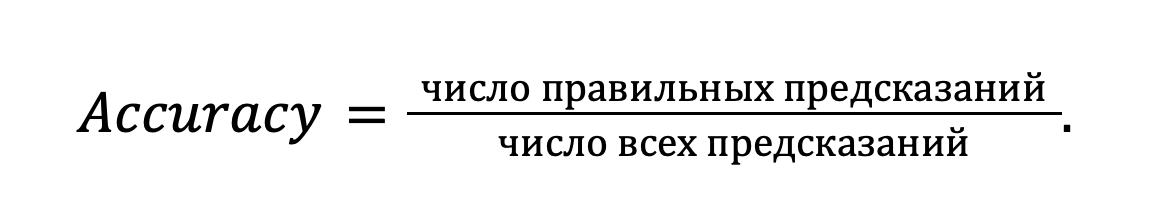
90 правильных ответов из 100 дают 0,9. Для бинарной классификации формулу записывают через четыре исхода:
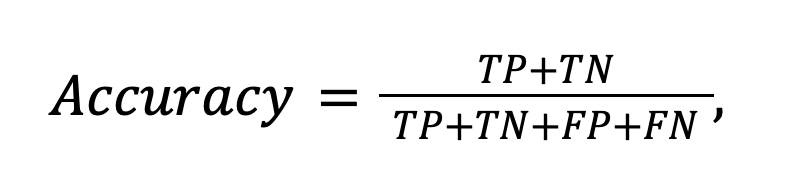
где TP и TN — правильные положительные и отрицательные ответы, а FP и FN — ложноположительные и ложноотрицательные. В нашем примере положительный ответ означает, что документ подходит под запрос.
У этой оценки есть два ограничения. Во-первых, здесь метрика учитывает правильность класса, но не место документа в выдаче. Во-вторых, при сильном дисбалансе классов итог в основном определяется частым классом. Если подходящих материалов мало, достаточно хорошо распознавать неподходящие, чтобы получить высокое значение.
Наглядный пример: высокая точность, неудобная выдача
Для нашего запроса возьмём пять материалов. Эксперт отметил, помогают ли они разобраться в теме. Пока считаем релевантным даже краткое полезное объяснение, а степень полезности добавим при расчёте NDCG.
| ID | Материал | Релевантен |
| d1 | Полный урок по оконным функциям | 1 |
| d2 | Практикум по LAG и LEAD | 1 |
| d3 | Обзор SQL с кратким объяснением OVER | 1 |
| d4 | Руководство по индексам | 0 |
| d5 | Инструкция по установке PostgreSQL | 0 |
Сравним три порядка этих же документов. Их обозначения будем использовать до конца статьи.
| Позиция | A: лучший порядок | B: полезное внизу | C: лучший урок третьим |
| 1 | d1 | d4 | d3 |
| 2 | d2 | d5 | d2 |
| 3 | d3 | d1 | d1 |
| 4 | d4 | d2 | d4 |
| 5 | d5 | d3 | d5 |
Во всех вариантах пусть оценки модели выше порога классификации: каждый документ назван релевантным. Верных ответов три, ошибок две. Метрика точности accuracy равна 3/5 = 60% для A, B и C. Но в B человек сначала увидит два неподходящих материала. Перестановка не меняет классы, поэтому показатель её не замечает.
Теперь добавим 95 нерелевантных документов. Модель, объявившая все 100 неподходящими, получит 97% верных ответов, пропустив три полезных. Вот что значит accuracy: совпадение классов, которое ещё не характеризует удобство поиска.
Когда accuracy — плохой выбор, а когда — допустимый
Доля правильных классификаций не подходит как основная оценка порядка результатов в поиске, рекомендациях или каталоге: здесь важно, что человек увидит первым.
Такая оценка допустима для классификационного компонента, например определения языка, если классы достаточно сбалансированы, а цена ошибок сопоставима. У фильтра документов дополнительно проверяют, сколько полезного он отбрасывает.
Что такое метрики ранжирования и зачем они нужны
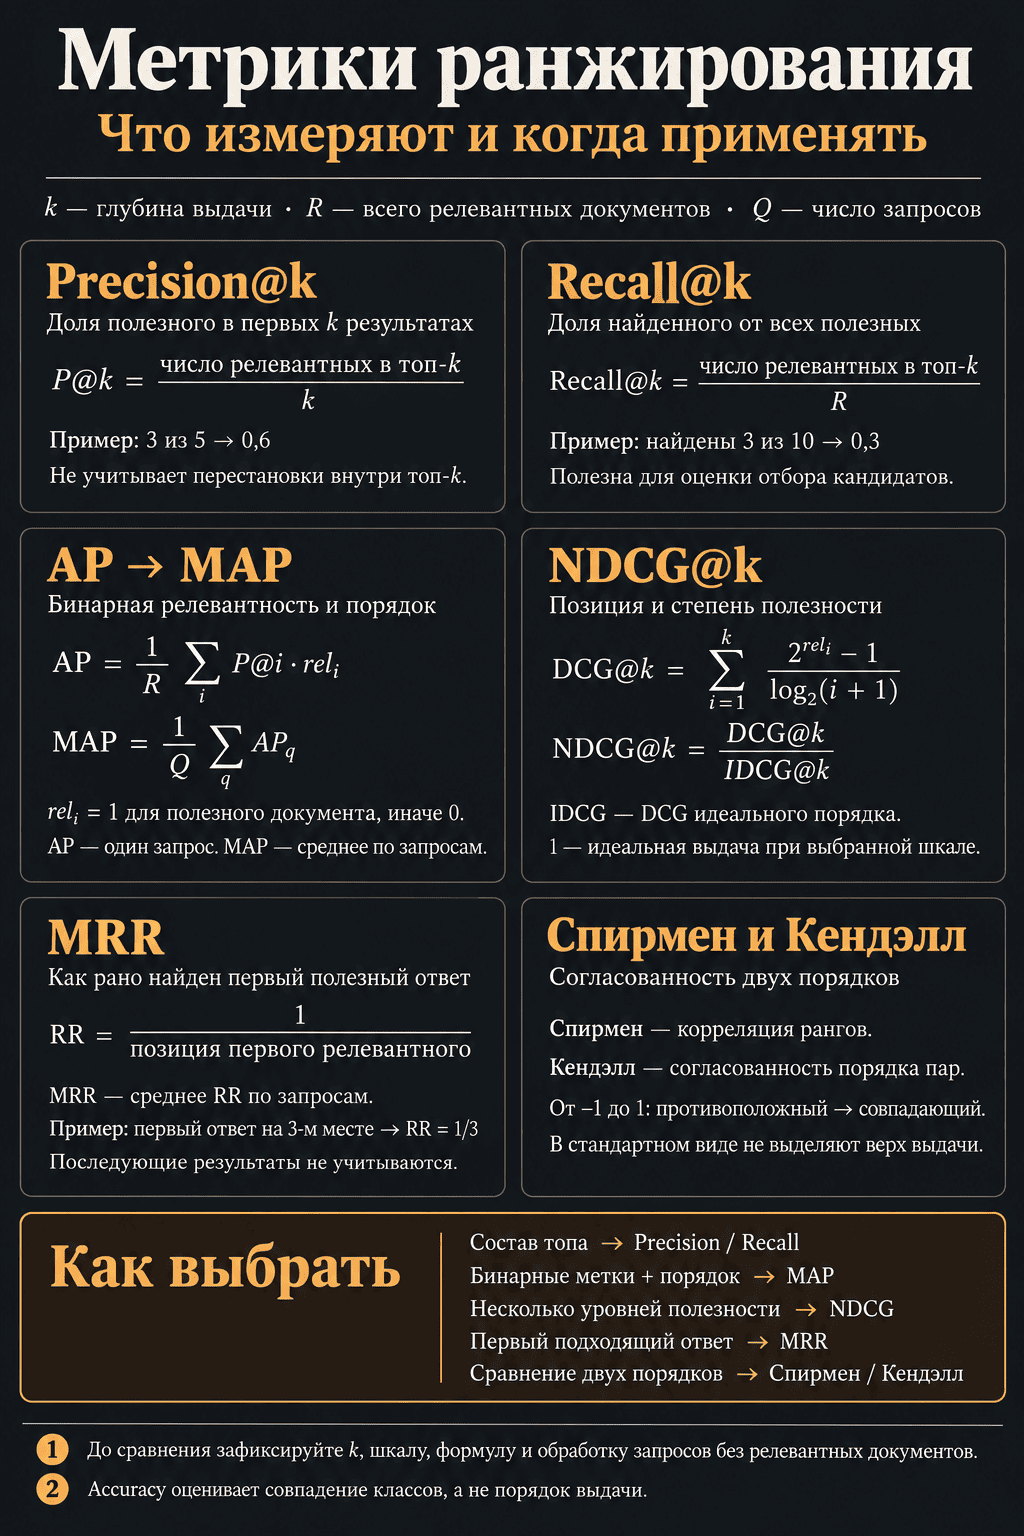
Метрика ранжирования сопоставляет порядок выдачи с известной релевантностью объектов. Сначала нужно определить, для кого и в каком контексте объект полезен.
Задача ранжирования: от поиска до рекомендаций
В поиске контекст задает запрос. Один и тот же урок может хорошо отвечать на «как работает LAG» и плохо — на «как оптимизировать JOIN». Поэтому релевантность оценивают для пары «запрос — документ».
В рекомендациях контекст задает пользователь. Новичку подойдет полный урок d1, человеку, знакомому с окнами, — практикум d2. Релевантность оценивают относительно потребностей юзера.
Модель присваивает кандидатам scores — числовые оценки для сортировки по убыванию. Они не обязаны быть вероятностями: для ранговой метрики прежде всего важен заданный ими порядок.
Ключевые требования к метрикам ранжирования: учёт позиции и небинарной релевантности
Для выдачи важны как минимум два свойства:
- где находится полезный объект;
- насколько он полезен.
Материал с одним упоминанием оконных функций отличается от подробного урока с примерами, хотя оба связаны с запросом.
В бинарной разметке объект либо релевантен, либо нет. В градуальной, или многоуровневой, ему присваивают степень релевантности: например, от 0 до 3. Метрику mAP обычно используют с бинарными метками, NDCG позволяет сохранить несколько уровней. При этом NDCG применима и к бинарным данным.
Обозначение @k задаёт глубину: NDCG@5 учитывает первые пять результатов. Значение k выбирают под интерфейс и сценарий: для блока рекомендаций и поиска по большой базе глубина может различаться.
MAP (Mean Average Precision) — метрика, которая учитывает порядок
Сначала посмотрим, как оценить состав выдачи. Допустим, система показала пять материалов. Какая доля из них действительно подходит под запрос пользователя? На этот вопрос отвечает precision, или точность: число релевантных результатов делят на число выбранных.
В ранжировании этот показатель часто считают только для первых k позиций — той части списка, которую оценивают. Его обозначают Precision@k, или сокращённо P@k:
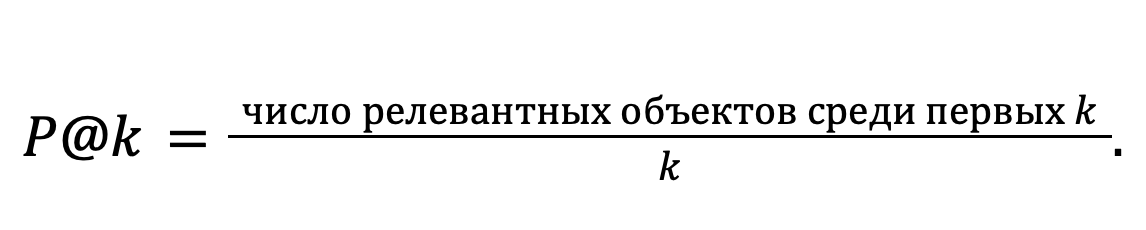
Здесь знаменатель — размер выбранной части выдачи. В A, B и C три релевантных документа из пяти: P@5 = 3/5 = 0,6. Метрика учитывает состав пятёрки, но не порядок внутри неё.
Average Precision, или AP, рассчитывают для одного запроса. Считаем precision на каждой позиции с релевантным документом, складываем значения и делим на общее число релевантных документов запроса в оценочном наборе:
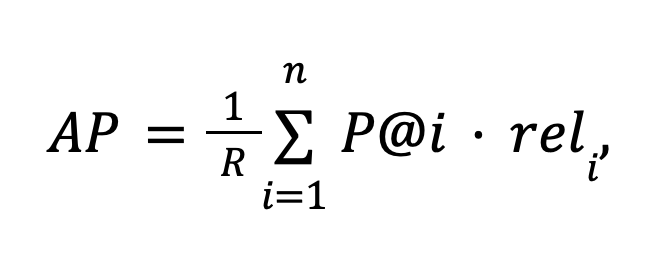
где R — число релевантных документов, n — длина оцениваемой выдачи, а relᵢ равно 1 для релевантного документа и 0 для нерелевантного. Если известный релевантный документ не попал в выдачу, он не добавляет ничего в сумму, но учитывается в R.
Посчитаем AP для наших двух выдач. Предположим, что в этом небольшом тестовом наборе всего три релевантных документа и обе системы вернули их все.
| Позиция | Релевантность A | P@i для A | Релевантность B | P@i для B |
| 1 | 1 | 1/1 | 0 | — |
| 2 | 1 | 2/2 | 0 | — |
| 3 | 1 | 3/3 | 1 | 1/3 |
| 4 | 0 | — | 1 | 2/4 |
| 5 | 0 | — | 1 | 3/5 |
Для A получаем:
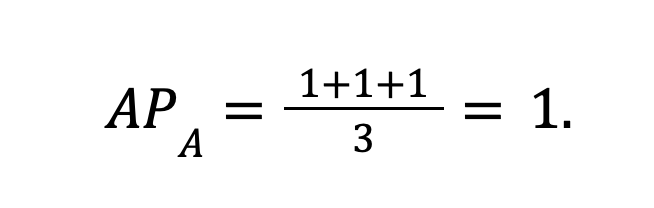
Для B:
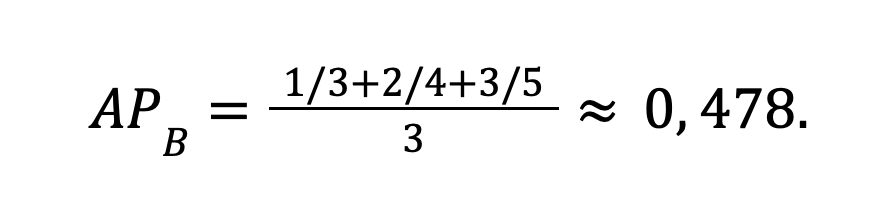
Прочерки в таблице означают, что позиция не даёт слагаемого в AP. Для C получаем единицу: все три релевантных документа стоят первыми, как в A. Их перестановку бинарные метки не различают.
Mean Average Precision, или mAP, — среднее AP по запросам. При обычном усреднении каждый запрос получает одинаковый вес, независимо от числа документов.
Добавим запрос «индексы PostgreSQL»: из тех же документов релевантен только d4. Пусть A и C поставили его первым, B — вторым. Получаем AP = 1 у A и C, AP = 1/2 у B: в сумму входит одна позиция.
| Запрос | AP системы A | AP системы B | AP системы C |
| Оконные функции SQL | 1 | 0,478 | 1 |
| Индексы PostgreSQL | 1 | 0,5 | 1 |
| MAP по двум запросам | 1 | 0,489 | 1 |
Для B: MAP ≈ (0,478 + 0,5) / 2 ≈ 0,489. Усредняем запросы одной системы, а не результаты A, B и C между собой. Для объяснения достаточно двух запросов; рабочий тест должен охватывать разнообразные задачи.
Важно
Для MAP@k фиксируют знаменатель AP@k: R или min(R, k). При делении на R и R > k единица недостижима: часть полезного неизбежно остается за пределами топа. При делении на min(R, k) идеальный топ получает единицу. Примем второй вариант для AP@k; полную AP делим на R.
При R = 0 формула не определена. Заранее решите, исключать такие запросы или учитывать с нулём, и применяйте правило ко всем моделям. Их долю отслеживайте отдельно.
NDCG (Normalized Discounted Cumulative Gain) — метрика для многоуровневой релевантности
Бинарная оценка подходит не всегда. Для запроса «оконные функции SQL» полный урок и краткая заметка могут быть релевантными, но приносить разную пользу. Введём шкалу:
| Оценка | Значение для нашего примера |
| 0 | Материал не отвечает на запрос |
| 1 | Есть полезное упоминание, но нет объяснения темы |
| 2 | Тема объяснена частично, есть отдельные примеры |
| 3 | Есть полноценное объяснение и практические примеры |
Для нашего запроса эксперт присвоил d1 оценку 3, d2 — 2, d3 — 1, d4 и d5 — 0. Это те же документы и те же порядки A, B и C; теперь сохраняем различия между полезными материалами.
NDCG строится на суммарной полезности выдачи с поправкой на позиции. Рассчитаем её по шагам.
Сначала задаём полезность оценки. Используем функцию gain(rel) = 2ʳᵉˡ − 1. Тогда уровни 0, 1, 2 и 3 превращаются в 0, 1, 3 и 7. Такой выбор сильнее выделяет наиболее релевантные документы. Существует и линейный вариант gain(rel) = rel: его результаты будут другими.
Затем уменьшаем вклад нижних позиций. Для этого делим полезность объекта на log₂(i + 1), где i — его место, начиная с единицы. Получаем Discounted Cumulative Gain (DCG) — накопленную полезность с учётом позиции.
- «Накопленная» означает, что мы складываем вклад всех документов до выбранной глубины k.
- «С учётом позиции» — что полезность каждого документа уменьшается по мере удаления от начала списка: один и тот же материал на первом месте принесёт больше баллов, чем на третьем.
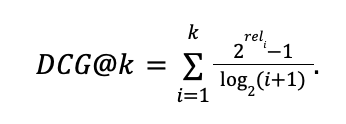
На первом месте делитель равен 1, на втором — примерно 1,585, на третьем — 2. Чем ниже документ, тем меньше его вклад.
Сравниваем результат с идеальным порядком. Сортируем все известные оценки релевантности для этого запроса по убыванию и рассчитываем DCG первых k объектов. Это IDCG@k — Ideal DCG. Сама сумма DCG зависит от доступных документов: у запроса с одним полезным материалом и у запроса с тремя будут разные максимумы. Деление на идеальную сумму показывает, насколько система приблизилась к лучшему порядку именно для этого запроса:
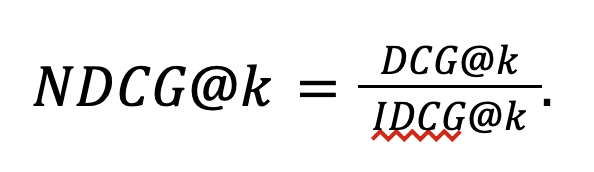
Вернёмся к A и C. В A оценки идут как [3, 2, 1, 0, 0], в C — как [1, 2, 3, 0, 0]. Считаем NDCG@3: сколько полезности дают первые три позиции по сравнению с лучшим возможным порядком.
Для C:
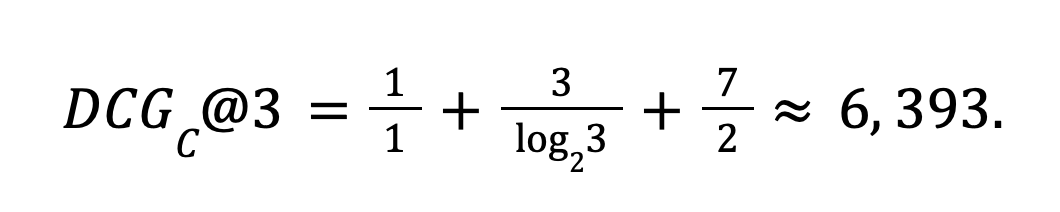
Идеальный порядок первых трёх оценок — [3, 2, 1]:
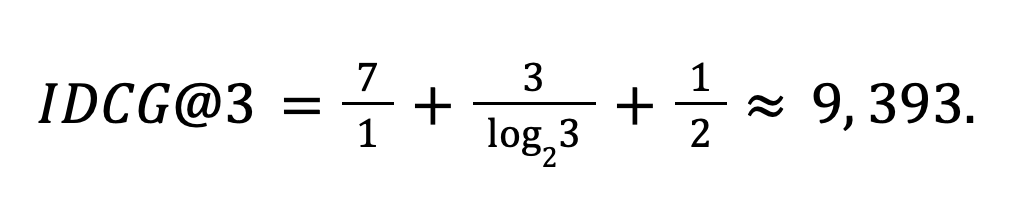
Следовательно, NDCG_C@3 ≈ 6,393 / 9,393 ≈ 0,681. У системы A порядок идеальный, поэтому NDCG_A@3 = 1.
Если считать любой документ с оценкой выше нуля релевантным, AP обеих систем будет равна 1. Все полезные результаты уже стоят перед бесполезными. NDCG различает эти выдачи, поскольку учитывает, какой именно полезный документ оказался первым.
Важно
Идеал строят по всему согласованному оценочному набору запроса, а не только по документам, которые конкретная модель сумела вернуть в топ. Иначе пропущенный лучший ответ может исчезнуть и из знаменателя. Варианты gain и позиционного дисконта нужно фиксировать в настройках.
При неотрицательных оценках и ненулевом IDCG значение NDCG находится от 0 до 1. Но 0,681 не означает «68,1% документов правильные»: это отношение дисконтированной полезности к идеальной для выбранного набора и формулы. Если все оценки нулевые, IDCG тоже равен нулю и требуется отдельное соглашение об обработке запроса.
MAP или NDCG: что и когда использовать
Обе метрики реагируют на порядок, но отвечают на разные вопросы. Первая оценивает, насколько рано найдены релевантные объекты. Вторая — насколько удачно распределены по позициям объекты разной полезности.
Бинарная или градуальная релевантность
MAP удобно использовать, когда критерий бинарный: документ отвечает на вопрос или нет, найденная карточка соответствует искомому товару или нет. Если разметка различает частичное и полное соответствие, NDCG позволяет учесть эту информацию без преобразования в два класса.
Чувствительность к позиции
В AP нет отдельного множителя, который задает вес места. Влияние позиции возникает через precision: полезный документ после нескольких неподходящих приносит меньший вклад. В NDCG позиционный вес задан явно через дисконт, а вклад также зависит от степени релевантности.
Перенос d1 на третье место в C замечает только NDCG, перенос полезных документов вниз в B — обе метрики. Универсального вывода о том, какая чувствительнее, нет: результат зависит от меток и перестановки.
Практические рекомендации по выбору
| Условие задачи | С чего начать | Что уточнить |
| Нужно находить несколько релевантных объектов, метки бинарные | MAP или MAP@k | Знаменатель AP@k и полноту разметки |
| Объекты различаются по степени полезности | NDCG@k | Шкалу, gain и глубину оценки |
| Важен первый подходящий ответ | MRR или MRR@k | Достаточно ли одного результата |
| Важен состав верхних k позиций, порядок внутри вторичен | Precision@k, Recall@k | Долю полезного в топе или долю найденного от всех полезных |
| Нужно сравнить два порядка одного набора объектов | Корреляции Кендэлла или Спирмена | Обработку совпадающих рангов |
Для первых трёх результатов учебного поиска подойдёт NDCG@3. Если перед ранжированием отдельный алгоритм отбирает 100 кандидатов из всей базы, для него полезно считать Recall@100, т.е. какую долю известных релевантных материалов удалось сохранить. Ранжировщик не сможет поднять наверх документ, которого среди кандидатов нет.
Другие метрики ранжирования
MAP и NDCG не покрывают все сценарии. Иногда важен только первый полезный ответ, а иногда нужно измерить согласованность двух полных упорядочений.
MRR (Mean Reciprocal Rank)
Для одного запроса Reciprocal Rank — величина, обратная позиции первого релевантного результата:
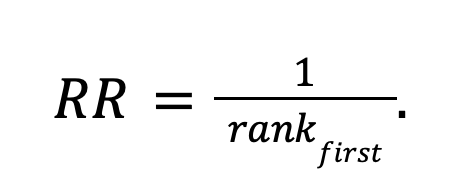
Если полезный документ первый, RR = 1; если второй — 0,5; если пятый — 0,2. MRR усредняет RR по запросам. При ограничении глубиной k запросу без релевантного результата в первых k позициях обычно присваивают ноль.
Для первого запроса RR у A и C равна 1, у B — 1/3. Для второго запроса значения равны 1, 1 и 1/2 соответственно. Поэтому MRR системы B по двум запросам — (1/3 + 1/2) / 2 ≈ 0,417. При этом MRR не покажет, что происходит после первого полезного документа. Две выдачи с релевантным результатом на первом месте получат одинаковую оценку, даже если остальные позиции одной из них заполнены мусором.
Поэтому MRR подходит, например, для навигационного поиска: пользователь ищет конкретный урок, страницу или инструкцию. Для подбора нескольких материалов одного найденного результата недостаточно, и потребуется другая оценка.
Ранговые корреляции: Кендэлл и Спирмен
Корреляция Спирмена сравнивает ранги одних и тех же объектов в двух упорядочениях. Коэффициент Кендэлла оценивает согласованность порядка пар: если статья A выше B в одном списке, сохраняется ли это отношение в другом? Значения близкие к 1 указывают на согласованность, близкие к −1 — на противоположный порядок.
Преподаватель упорядочивает пять материалов, а мы сравниваем его порядок с модельным. Такой метод оценки ранжированием выражает относительные предпочтения, но не величину различий. Для NDCG нужны отдельные баллы релевантности.
Стандартные коэффициенты не выделяют верх выдачи позиционным дисконтом. Согласованность длинного списка ещё не гарантирует удачный топ. При одинаковых оценках учитывают связанные ранги — объекты, между которыми эксперт не установил различий.
Как оценивать ранжирование на практике
Заранее определите данные и правила расчёта. Параметры модели подбирайте на валидационной выборке, итог оценивайте на отдельной тестовой.
Собрать размеченный датасет (набор данных) с релевантностью
Минимальная запись для поисковой задачи содержит:
- идентификатор запроса,
- идентификатор документа,
- оценку релевантности.
Предсказание модели хранят отдельно или добавляют в соответствующую строку. Один документ может встречаться с разными запросами и разными метками.
Проверьте инструкцию на небольшой общей выборке: дайте одни пары нескольким разметчикам и разберите расхождения. Если оценки релевантности расходятся из-за неясных критериев, сначала уточните критерии, затем размечайте основной набор.
Разметка только выдачи одной модели ограничивает тест её кандидатами. Объедините результаты сравниваемых систем и дополните документами из других способов поиска. Неразмеченный объект не обязательно нерелевантен: возможно, полезный материал ещё не проверили.
Выбрать метрику под задачу
Запишите основной показатель и правила его расчёта до сравнения моделей. Для нашего поиска договорённость может выглядеть так:
«NDCG@3, оценки от 0 до 3, gain = 2ʳᵉˡ − 1, логарифмический дисконт, равный вес запросов; запросы без положительных меток оцениваем отдельно».
Рассчитать метрику на тестовой выборке
Метрику сначала считают внутри запроса, затем усредняют по запросам. Нельзя сложить документы разных запросов в общий список: модель может использовать разные диапазоны scores, а пользователь никогда не увидит такую объединенную выдачу.
Каждая строка массива ниже соответствует одному из двух запросов, а столбцы — документам d1–d5. Метки одного документа могут различаться между запросами. Для «индексов PostgreSQL» материал d4 получает 3, остальные — 0.
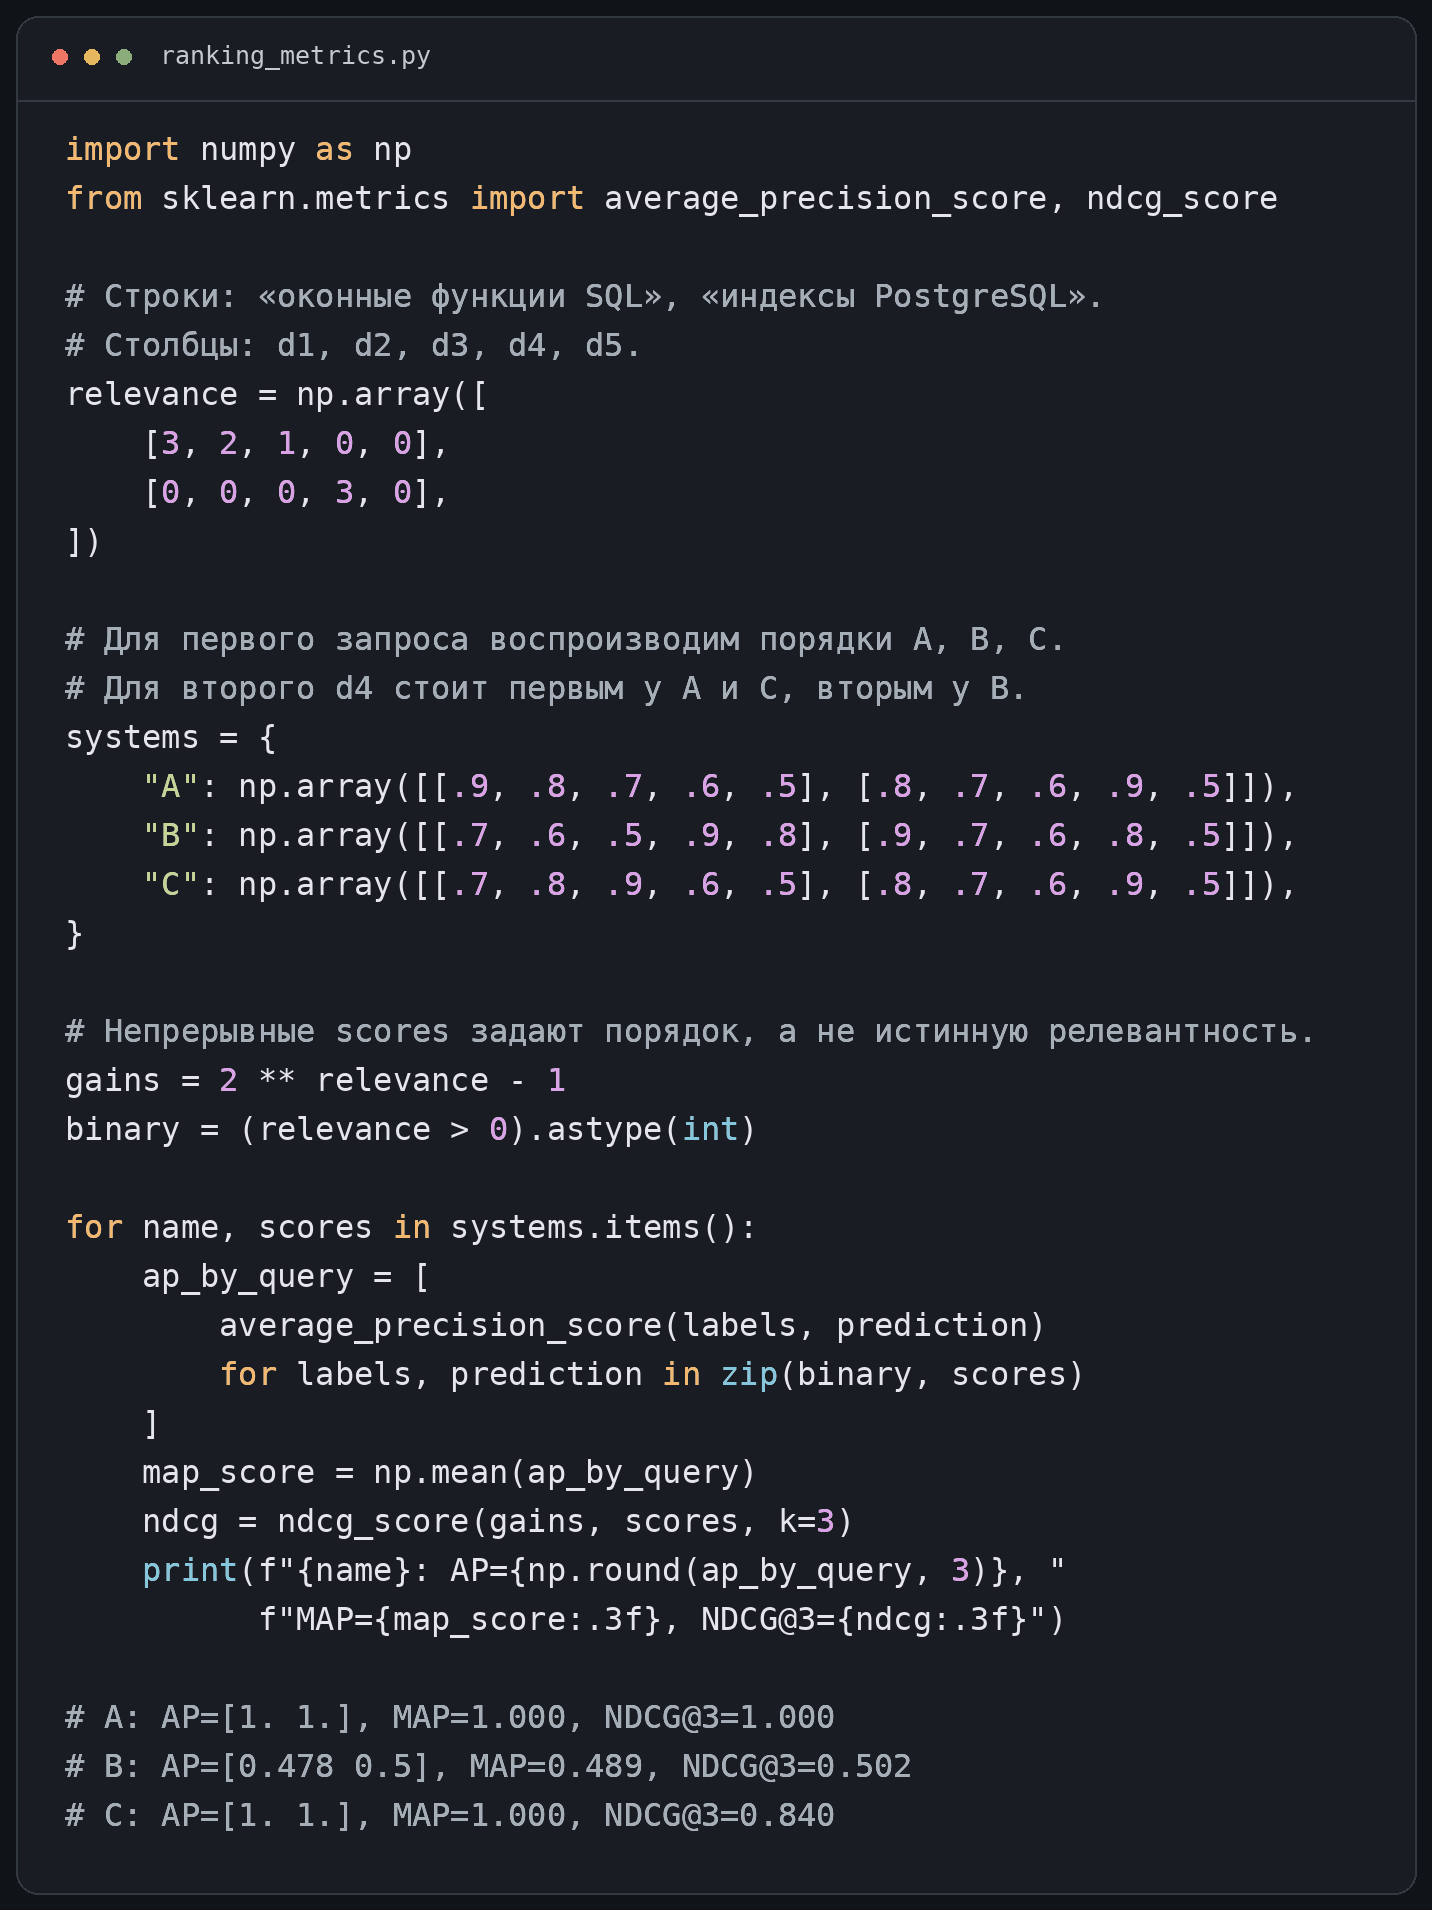
Здесь NDCG@3 уже усреднена по двум запросам. Поэтому у C получается 0,840: среднее между 0,681 для оконных функций и 1 для индексов.
В ndcg_score передаем преобразованные оценки, чтобы воспроизвести выбранную экспоненциальную полезность. Если передать исходные 0, 1, 2 и 3, получится линейный gain и другой результат.
При разных scores и полном наборе average_precision_score воспроизводит наш расчёт AP. Функция перебирает пороги; при равных scores результат может отличаться от оценки фиксированного порядка. MAP@k она автоматически не считает: здесь усредняем полную AP по запросам.
Интерпретировать результаты
Допустим, средняя NDCG@5 выросла с 0,72 до 0,75. Это прирост на 0,03, или примерно на 4,2% относительно исходного значения. Он относится к выбранной офлайн-метрике и сам по себе не означает такой же рост кликов, завершенных уроков или покупок.
Проверьте изменения по запросам: несколько сильных улучшений могут скрыть ухудшение остальных. Сравните короткие и длинные запросы, популярные и редкие темы, группы пользователей, представленные в разметке.
Порога хорошей NDCG нет: значение зависит от запросов, кандидатов и разметки. Сравнивайте модели на одном тесте, а не с числами из чужих статей.
Продвинутый уровень: когда метрик становится больше, а задача — сложнее
В работающем сервисе удачно отсортировать размеченные документы недостаточно. Нужно учитывать скорость ответа, разнообразие рекомендаций и поведение пользователей. На этом этапе выбор метрики становится частью проектирования всей системы.
Многокритериальная оптимизация: как выбирать между метриками в реальном проекте
Представим, что новая модель улучшает NDCG@5, но отвечает заметно медленнее. Или предлагает пять почти одинаковых уроков: каждый релевантен, но вместе они дают меньше выбора, чем более разнообразная подборка. Одной NDCG эти эффекты не описать.
Задайте основную цель и ограничения: например, улучшать NDCG@3 при допустимой задержке и без дублей. Если одна модель точнее, а другая быстрее, проверьте, оправдывает ли релевантность дополнительное ожидание. Произвольная сумма показателей скроет этот компромисс.
А/B-тестирование ранжирования: как сравнивать модели на живых пользователях
Офлайн-оценка помогает отсеять неудачные варианты до запуска. A/B-тест проверяет, меняется ли поведение пользователей в реальном интерфейсе. Пользователей случайно распределяют между вариантами и, как правило, закрепляют за ними версию выдачи на время эксперимента.
В учебном поиске оценивайте переход к изучению материала. Одного клика недостаточно: заголовок может привлечь без пользы для обучения. Проверьте начало урока, быстрые возвраты в поиск и переформулировки запроса.
До запуска задают основную метрику, значимый для продукта эффект, объем наблюдений и правила завершения. Защитные показатели отслеживают ошибки, задержки и отказы. При проверке многих метрик и сегментов учитывают множественные сравнения.
Кастомизация метрик: как адаптировать NDCG и MAP под бизнес-задач
В NDCG можно изменить gain или дисконт под продуктовый сценарий. Проверьте на понятных примерах, предпочитает ли новая формула более полезные выдачи. Назовите и опишите модификацию так, чтобы её нельзя было спутать со стандартным расчетом.
Для mAP можно взвешивать запросы по частоте: массовые сценарии сильнее повлияют на итог. Назовите результат взвешенной mAP и укажите веса. Сохраняйте рядом обычное среднее, чтобы замечать ухудшения редких запросов.
Перейти от расчета метрик к поисковому сервису поможет курс «Продвинутое машинное обучение». В модуле «Ранжирование и матчинг (сопоставление)» разбирают метрики, функции потерь, алгоритмы ранжирования, поиск ближайших соседей и сбор данных. Завершается модуль разработкой сервиса на основе моделей ранжирования.
В блоке «Рекомендательные системы» есть офлайн-оценка и валидация, модели ранжирования и онлайн-метрики. Курс рассчитан на специалистов с опытом в машинном обучении (ML). Изучите программу и выберите направление, которое соответствует вашим рабочим задачам. Кроме того, выпускники и студенты программы могут участвовать в проекте ускоренного трудоустройства в MAGNIT TECH на позицию инженера машинного обучения.
Заключение
Выбор метрики начинается с задачи: нужен ли пользователю один быстрый ответ или несколько результатов разной полезности? От этого зависят разметка и способ расчёта. В отчёте фиксируйте не только название метрики, но и глубину оценки, формулу и правила усреднения.
Начните с небольшого эксперимента: разметьте документы для нескольких запросов и сравните выдачи. Вручную разберите расхождения значений — так станет понятнее, какие ошибки они замечают, а какие пропускают. А если хотите освоить новую область в ML под руководством ведущих специалистов, приходите на продвинутый курс в Karpov Courses.