
Множественные эксперименты: теория и практика A/B-тестирования
Интернет-магазин тестирует пять новых страниц товара. Одна показывает значимый рост конверсии, но можно ли объявить ее победителем? Множественные тесты увеличивают риск принять случайное колебание за реальный эффект. В статье разберем, как учитывать множественные сравнения, чем отличаются FWER и FDR, когда применять поправки Бонферрони, Холма и Бенджамини—Хохберга и как выполнить расчеты в Python.
Содержание
- Проблема множественных сравнений: почему один тест — не всегда один тест
- Когда множественные эксперименты необходимы, а когда — излишни
- Где необходимо множественное тестирование
- Ключевые понятия: FWER и FDR
- Поправка Бонферрони
- Альтернативы Бонферрони: как сохранить мощность
- Множественные эксперименты в продуктовой аналитике
- Как применять поправки на практике
- Как не ошибиться: частые ошибки и заблуждения
- От теории к практике: как перестать бояться множественных сравнений и начать применять их в работе
- Заключение
Проблема множественных сравнений: почему один тест — не всегда один тест
Итак, команда интернет-магазина запустила один эксперимент, где сравнивает с исходной страницей сразу пять новых вариантов. Чтобы оценить найденный рост конверсии, нужно учитывать все эти проверки. Рассмотрим, как их считать и почему от их числа зависит риск ложного вывода.
Что такое множественное тестирование и где оно встречается
В продуктовой команде тестом часто называют весь эксперимент: распределили пользователей, показали разные страницы, собрали данные. В статистике тест — отдельная проверка гипотезы. Поэтому один продуктовый эксперимент может включать несколько статистических тестов.
В нашем магазине исходная страница A служит контролем. Для каждого нового варианта — B, C, D, E и F — проверяют свою нулевую гипотезу: его конверсия равна конверсии контроля. Пять вариантов дают пять проверок. Если для каждого варианта отдельно проверять еще выручку на пользователя и долю пользователей, добавивших товар в корзину, получится пятнадцать.
Множественное тестирование возникает, когда мы проверяем несколько гипотез и используем результаты для связанных выводов. Такой набор называют семейством гипотез. В нашем примере пять сравнений по конверсии образуют семейство: команда готова объявить успешным любой вариант, который покажет рост. Если основанием для успеха может стать и другая метрика, ее проверки тоже нужно учесть.
Похожая ситуация возникает, когда мы ищем улучшения в разных сегментах. Например, среди новых покупателей, постоянных клиентов и пользователей мобильных устройств. Каждая дополнительная проверка дает еще одну возможность найти случайное различие.
Ошибка первого рода и ее накопление при множественных проверках
Ошибка первого рода — это ложная тревога. В нашем примере она возникает, когда тест показывает разницу между страницами, хотя на самом деле их конверсии равны. Мы принимаем случайное колебание за реальный эффект и отвергаем верную нулевую гипотезу.
Чтобы ограничить этот риск, до начала теста задают уровень значимости α. Обычно выбирают 0,05, или 5%. Представим, что мы много раз повторяем эксперимент, в котором страницы на самом деле работают одинаково. Если все условия теста соблюдены, он будет давать ложную тревогу в среднем не более чем в 5% случаев. Это не значит, что наш конкретный вывод ошибочен с вероятностью 5%.
Результат теста оценивают по p-value. Допустим, истинные конверсии страниц равны. Насколько вероятно тогда получить такую же или еще более сильную разницу в результатах? На этот вопрос и отвечает p-значение с учетом модели теста. Чем оно меньше, тем хуже данные согласуются с нулевой гипотезой. Если p-value ниже выбранного α, разницу называют статистически значимой.
Но каждый новый тест дает еще один шанс получить ложную тревогу. Если проверить пять вариантов и объявить успех по любому p < 0,05, общий риск ошибки может превысить 5%. Даже если каждый отдельный тест работает правильно.
Наглядный пример: как растет вероятность ложного вывода
Представим, что все нулевые гипотезы верны, проверки независимы и каждая ошибается с вероятностью ровно 5%. Тогда вероятность обойтись без ложной тревоги в одной проверке равна 0,95, а в m проверках — 0,95ᵐ. Здесь m — число проверок.
Чтобы найти вероятность хотя бы одной ошибки, вычтем вероятность отсутствия ошибок из единицы:
P(хотя бы одна ошибка) = 1 − (1 − α)ᵐ.
Для пяти независимых проверок получаем 1 − 0,95⁵ ≈ 22,6%. Для двадцати — уже 64,2%. Это вероятность хотя бы одной ложной находки во всем наборе, а не вероятность ошибки каждого отдельного теста.
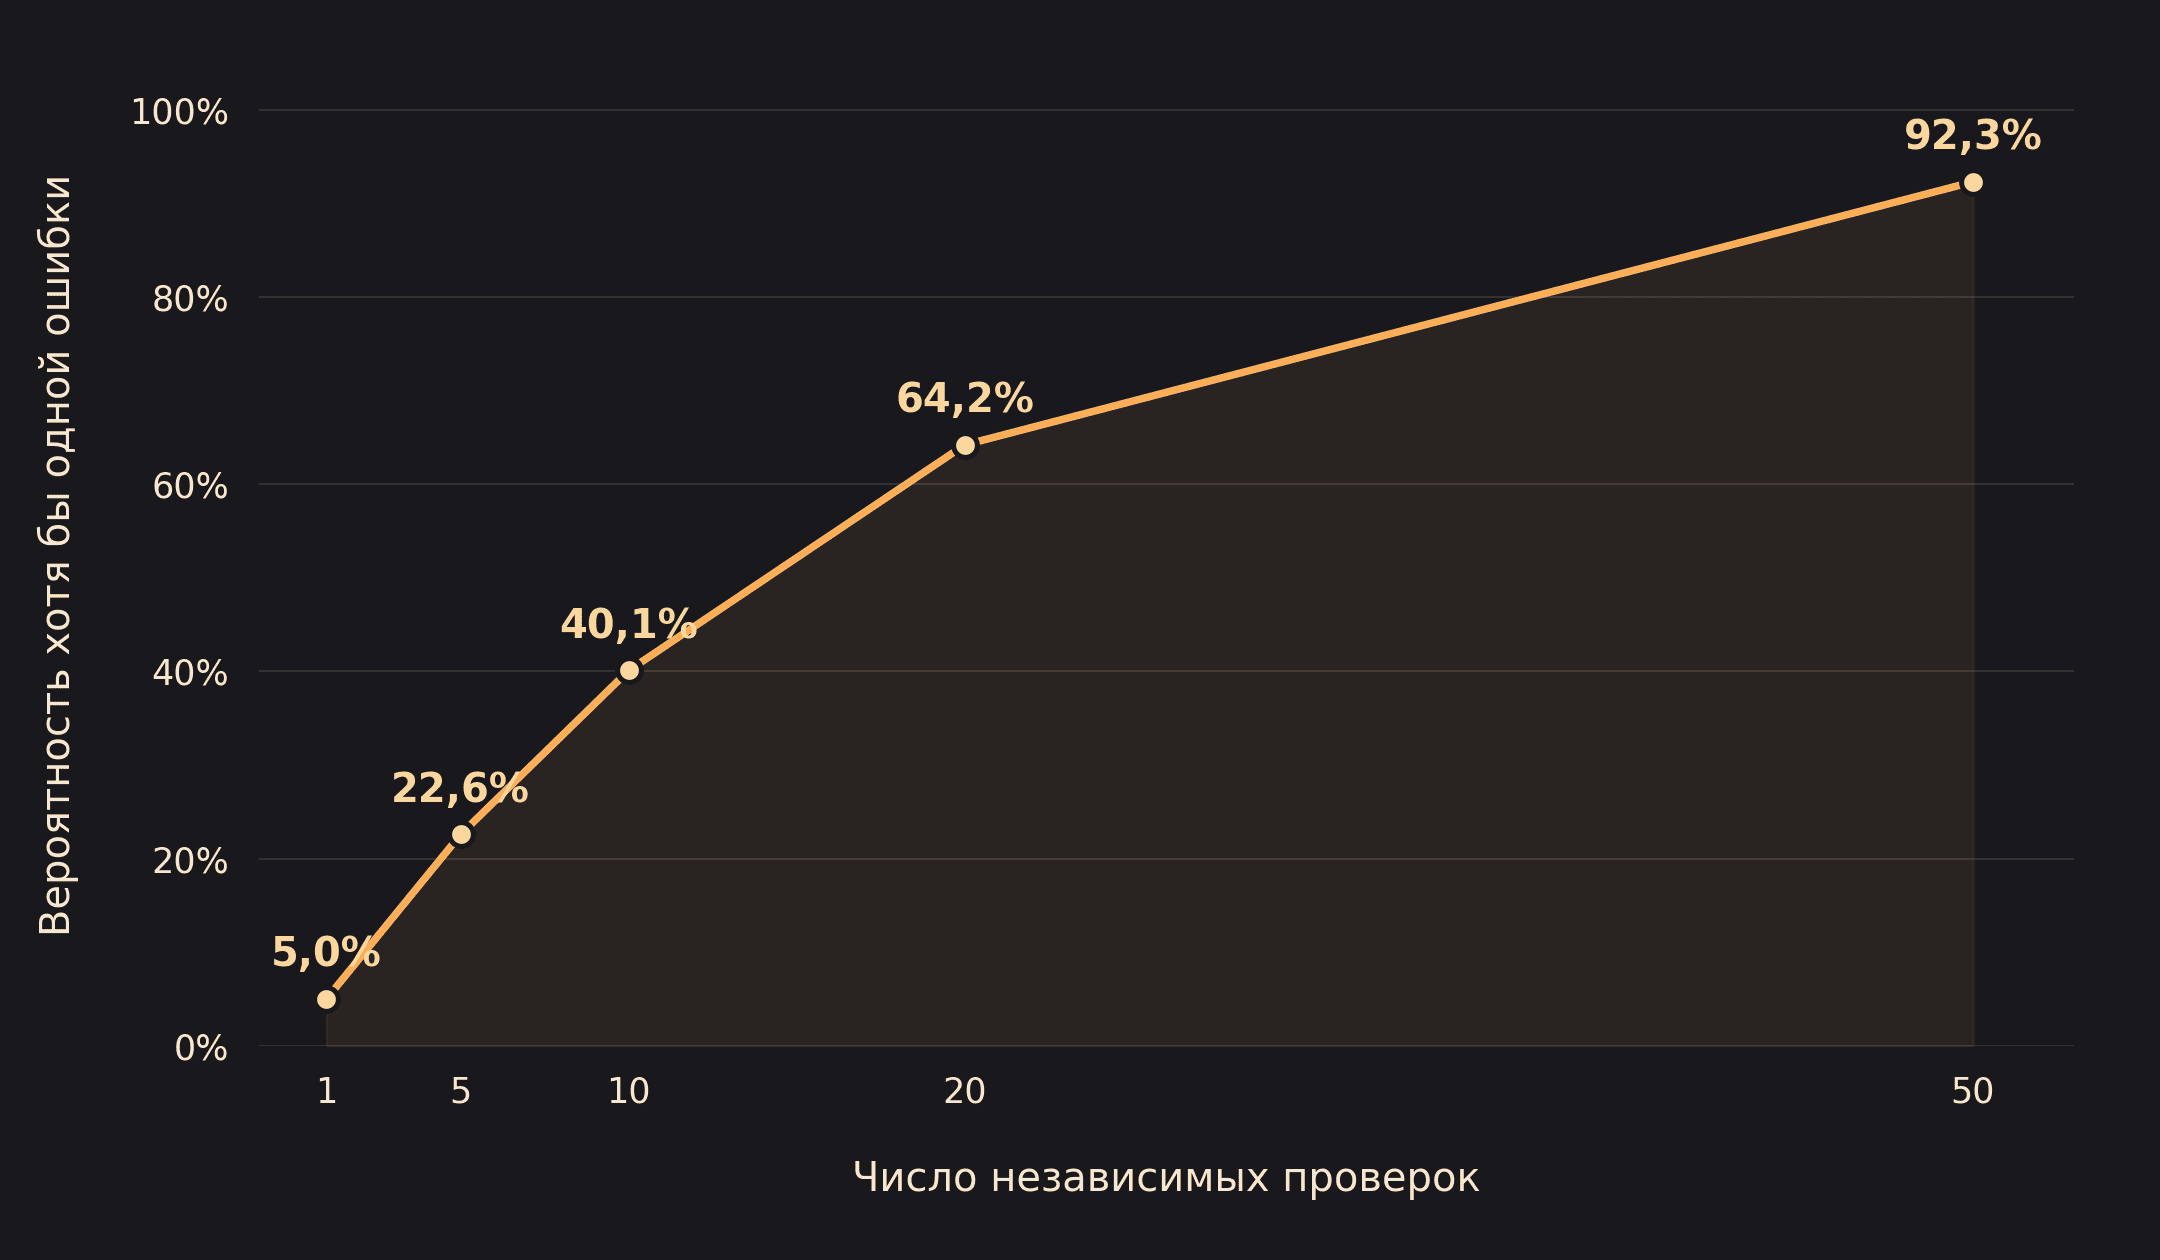
В нашем магазине все пять новых страниц сравнивают с одной и той же исходной страницей. Если ее конверсия случайно вырастет или упадет, это повлияет сразу на все сравнения. Поэтому проверки связаны между собой, а формула выше подходит только для независимых проверок. Риск хотя бы одной ошибки здесь тоже есть, но считать его равным 22,6% нельзя.
Когда множественные эксперименты необходимы, а когда — излишни
Бывает, что несколько сравнений помогают решить задачу. Но если команда начнет проверять все доступные метрики и группы пользователей просто в поисках значимого результата, риск ложных находок вырастет.
Где необходимо множественное тестирование
Множественная проверка гипотез нужна, когда одного сравнения мало, чтобы ответить на вопрос бизнеса. Вот примеры таких задач:
- Выбрать новую страницу. В нашем магазине пять вариантов. Команда сравнивает каждый с исходной страницей, чтобы узнать, какие повышают конверсию.
- Проверить несколько метрик. Команда готова признать новую страницу успешной, если вырастет конверсия или выручка на пользователя. Значит, нужно учесть обе проверки.
- Решить, кому показать новую страницу. Возможно, она помогает новым покупателям, но мешает постоянным. Команда проверяет результат в нескольких группах пользователей, чтобы решить, где запустить обновление.
- Найти идеи для будущих экспериментов. Аналитик проверяет много предположений и отбирает перспективные. Такие находки еще предстоит подтвердить на новых данных.
Когда необходимости нет
Если успех оценивают только по одной метрике, а остальные помогают понять поведение пользователей, поправка на них не нужна. Но нельзя задним числом объявить успех по второстепенной метрике, если основная не выросла.
Слишком строгая поправка мешает заметить реальный эффект. Поэтому сначала решите, что считать успехом, а затем выберите, какие проверки учитывать и какую поправку применять.
Ключевые понятия: FWER и FDR
Одно дело — выбрать страницу и показать ее всем покупателям. Другое — собрать идеи, которые команда еще проверит. Цена ошибки разная, поэтому и контролировать ошибки можно по-разному.
FWER (Family-Wise Error Rate) — контроль хотя бы одной ошибки
FWER — вероятность получить хотя бы одну ложную находку среди всех проверяемых гипотез. В нашем примере с магазином — найти различие между новой и исходной страницей там, где его на самом деле нет.
Обозначим число ложных находок через V. Тогда:
FWER = P(V ≥ 1).
Контролировать FWER на уровне 5% — значит ограничить риск хотя бы одной такой ошибки во всем семействе гипотез: он должен быть не выше 5%.
Этот подход полезен, когда по результатам теста команда принимает дорогое решение. Например, запускает новую страницу для всех покупателей, меняет тариф или алгоритм рекомендаций.
FDR (False Discovery Rate) — контроль доли ложных отклонений
FDR показывает, какую долю среди значимых результатов в среднем составляют ложные находки. Здесь нас интересует уже не сам факт ошибки, а доля ошибок в списке результатов.
Обозначим число всех значимых результатов через R, а ложных — через V. В одном анализе доля ошибок равна V/R. Если значимых результатов нет, считаем эту долю нулевой. Формула учитывает оба случая:
FDR = E[V / max(R, 1)].
Буква E означает усреднение по множеству повторений процедуры. Поэтому контроль FDR на уровне 5% не обещает максимум одну ошибку в каждом списке из двадцати находок. В отдельном списке ошибок может быть больше, меньше или ни одной.
Такой подход помогает отбирать идеи для будущих экспериментов. Например, магазин проверяет десятки способов персонализировать страницу. Команда готова включить в список часть ложных находок, чтобы не упустить перспективные идеи. Затем их проверят на новых данных.
FWER ограничивает риск хотя бы одной ложной находки, а FDR — среднюю долю ложных находок среди значимых результатов. Выбор зависит от задачи: нельзя переходить к FDR только потому, что с ним удалось получить значимость.
Поправка Бонферрони
Поправка Бонферрони для множественных сравнений работает по простому правилу: делим общий уровень значимости α на число проверок m.
Порог для отдельной проверки = α / m
В нашем магазине пять новых страниц сравнивают с контролем. Чтобы риск хотя бы одной ложной находки не превышал 5%, для каждого теста задают порог:
0,05 / 5 = 0,01
Теперь результат p = 0,03 не считается значимым: он выше нового порога.
Можно пойти другим путем: умножим каждое p-значение на число проверок и сравним с исходным α = 0,05. Если получилось больше единицы, оставляем единицу. Например:
p = 0,008 → после поправки 0,008 × 5 = 0,04
Результат остается значимым: 0,04 < 0,05. Оба способа дают одинаковый ответ. Выберите один: одновременно умножать p-value и делить порог не нужно.
Почему это работает? Риск хотя бы одной ложной тревоги не может быть выше суммы рисков отдельных ложных тревог. Мы выделили каждой из пяти проверок по 1%, значит, общий риск не превысит 5%. Метод работает и со связанными проверками, например, когда все страницы сравнивают с одним контролем.
За простоту приходится платить. Чем больше проверок, тем ниже порог и тем труднее заметить реальный эффект. При ста сравнениях порог составит всего 0,0005. Чтобы сохранить прежний шанс обнаружить эффект заданного размера, понадобится больше данных, а значит, больше трафика и времени.
Альтернативы Бонферрони: как сохранить мощность
Можно ли контролировать ошибки и при этом реже пропускать полезные изменения? Да. Например, метод Холма сохраняет ту же гарантию, что и Бонферрони, но позволяет обнаружить больше значимых результатов. А если задача допускает контроль FDR, можно рассмотреть метод Бенджамини—Хохберга.
Метод Холма (Holm-Bonferroni) — последовательная корректировка
Этот метод множественных сравнений контролирует тот же риск, что и Бонферрони: вероятность хотя бы одной ложной находки. При этом на тех же данных Холм найдет не меньше значимых результатов, а иногда — больше.
Разница в порогах. Бонферрони задает один порог для всех проверок, а Холм постепенно его повышает:
- Располагаем p-value от меньшего к большему.
- Самое маленькое сравниваем с α/m, следующее — с α/(m − 1), затем — с α/(m − 2).
- Если p-значение выше своего порога, останавливаемся. Этот результат и все следующие считаем незначимыми.
Допустим, пять сравнений страниц в нашем магазине дали такие результаты:
| Место после сортировки | p-value | Порог Холма при α = 0,05 | Решение |
| 1 | 0,004 | 0,0100 | Значимый результат |
| 2 | 0,009 | 0,0125 | Значимый результат |
| 3 | 0,014 | 0,0167 | Значимый результат |
| 4 | 0,032 | 0,0250 | Незначимый — останавливаемся |
| 5 | 0,200 | — | Незначимый: остановились на предыдущем шаге |
Бонферрони признал бы значимыми только первые два результата: их p-value меньше 0,01. Метод Холма позволяет признать значимым и третий. При этом риск хотя бы одной ложной находки по-прежнему не превышает 5%.
Метод Бенджамини—Хохберга (BH) — контроль FDR
BH контролирует среднюю долю ложных находок среди значимых результатов. Сортируем p-value от меньшего к большему и для каждой позиции i считаем порог i × q/m, где q — выбранный уровень FDR, а m — число проверок.
Затем находим последнее значение, которое не превышает свой порог. Его и все предыдущие результаты признаем значимыми. В отличие от Холма, на первом превышении порога не останавливаемся.
В нашем примере при q = 0,05 пороги равны 0,01; 0,02; 0,03; 0,04; 0,05. Четвертое p-value — 0,032 — проходит порог 0,04, а пятое — 0,200 — не проходит. Значит, BH признает значимыми первые четыре результата. Если ни одно значение не проходит свой порог, значимых результатов нет.
Гарантия BH действует для независимых проверок и некоторых видов положительной зависимости. Если проверки связаны, нужно убедиться, что условия метода выполнены. При произвольной зависимости можно использовать более строгий метод Бенджамини—Йекутиели.
Сравнение подходов: что выбрать для продуктовых A/B-тестов
| Метод | Что контролирует | Значимых результатов в примере | Когда рассмотреть |
| Бонферрони | FWER | 2 | Нужен простой общий порог для проверок |
| Холм | FWER | 3 | Важен риск хотя бы одной ложной находки |
| BH | FDR | 4 | Нужен список кандидатов с контролем ожидаемой доли ошибок |
Множественные эксперименты в продуктовой аналитике
С поправками разобрались. Теперь вернемся к магазину: какие сравнения нужны команде, сколько данных собрать и как выбрать страницу для запуска?
A/B/n-тестирование: сравнение нескольких групп
В A/B/n-тесте одновременно проверяют несколько вариантов. Считать нужно сравнения, а не группы.
В нашем магазине шесть групп: исходная страница A и пять новых. Если каждую новую страницу сравнивают только с A, получаем пять проверок. Если сравнивают все страницы друг с другом — уже пятнадцать:
6 × 5 / 2 = 15
Найти страницы лучше исходной и выбрать лучшую среди всех — разные задачи. Допустим, B и C значимо лучше A, а у B конверсия чуть выше, чем у C. Это еще не доказывает, что B лучше C: разница может быть случайной. Нужно сравнить их напрямую, допустим, по заранее составленному плану или в новом эксперименте.
Множественные метрики в одном A/B-тесте
На новую страницу могут чаще кликать, но покупать столько же. Чтобы понять, удался ли эксперимент, заранее определите роль каждой метрики.
- Основная метрика показывает, достигли ли мы цели. Например, выросла ли доля пользователей, которые купили товар за семь дней после попадания в тест.
- Защитные метрики помогают проверить, не навредили ли изменения. Например, не упала ли выручка и не стало ли больше ошибок. Заранее решите, какое ухудшение допустимо и как будете его проверять. Если значимого вреда не нашли, это еще не доказывает безопасность. Данных могло просто не хватить.
- Диагностические метрики помогают объяснить результат. Например, доля добавлений в корзину показывает, на каком шаге изменилось поведение покупателей. Эти показатели можно изучать, не объявляя каждое колебание доказанным эффектом.
Правило успеха тоже важно. Если достаточно улучшить хотя бы одну из трех метрик, нужно учесть все три шанса объявить успех. Если требуется улучшить все три, для общего вывода «улучшились все» поправка по числу метрик может не понадобиться. Но отдельные выводы по каждой метрике требуют своего контроля ошибок.
Дизайн эксперимента с учетом поправок
Начнем с вопроса: «При каком результате мы запустим новую страницу?» Затем составим план:
- Выбрать варианты, основные метрики и нужные сравнения.
- Определить, какие гипотезы образуют одно семейство и что контролировать — FWER или FDR.
- Задать допустимый риск ошибки, выбрать поправку и решить, ищем изменения в обе стороны или только в одну.
- Указать минимальный полезный эффект и мощность — с какой вероятностью тест должен его обнаружить.
- Рассчитать выборку с учетом поправки. Решить, как распределить трафик и сколько времени наблюдать за каждым пользователем.
- Записать, когда закончим тест, какие данные исключить и какие группы пользователей анализировать отдельно.
Как применять поправки на практике
Эксперимент завершен, данные проверены, p-значения для пяти сравнений рассчитаны. Теперь применим поправки в Python с помощью функции multipletests из библиотеки statsmodels.
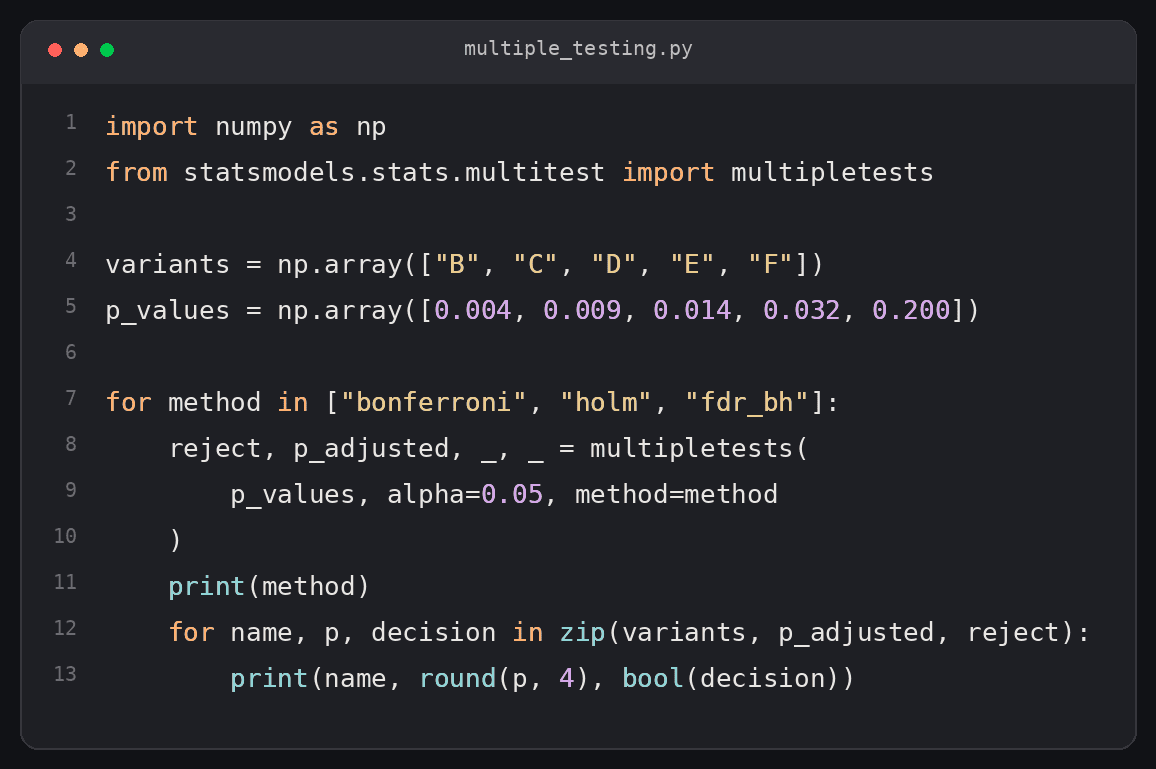
Скорректированные p-value сравнивают с 0,05. В коде мы используем три метода, чтобы показать разницу. В реальном эксперименте метод выбирают заранее. Нельзя перейти с Холма на BH только ради значимого результата: вместо риска хотя бы одной ошибки вы начнете контролировать среднюю долю ложных находок.
В двустороннем тесте значимый результат говорит о различии, но не обязательно об улучшении. Проверьте, выросла метрика или упала и насколько.
Как не ошибиться: частые ошибки и заблуждения
Представим, что конверсия в магазине не выросла, зато среди десятка других метрик нашлась значимая. Можно ли объявить успех? Разберем эту и другие ситуации, в которых легко сделать неверный вывод.
«Я проверю post-hoc, если ANOVA покажет значимость»
Дисперсионный анализ (ANOVA) проверяет, равны ли средние во всех группах. Значимый результат говорит, что где-то есть различие, но не показывает, между какими группами.
Допустим, одна страница действительно отличается от остальных. ANOVA замечает это. Но если затем сравнить все остальные страницы друг с другом без поправки, можно найти случайные различия и между ними.
Поэтому для дальнейших сравнений нужен подходящий метод. Например, Тьюки для всех пар средних, если выполнены его условия, или Холм для выбранного набора проверок.
«Метод Бонферрони — единственный правильный способ»
Выбирайте метод множественных сравнений под задачу и данные. Бонферрони — лишь один из вариантов. Холм контролирует тот же риск хотя бы одной ошибки и позволяет найти не меньше значимых результатов. BH контролирует среднюю долю ложных находок и подходит для других задач.
«Можно скорректировать только значимые результаты»
Аналитик проверил двадцать гипотез, нашел три p-значения ниже 0,05 и применил поправку только к ним. Но у случайности было двадцать шансов создать ложную находку, а поправка учитывает всего три.
Корректировать нужно весь заранее определенный набор проверок. Нельзя убирать из него результаты только потому, что они оказались незначимыми.
Похожая ловушка — каждый день проверять результаты и останавливать тест, как только появилась значимость. Так команда получает много шансов поймать случайный всплеск. Поправка на пять страниц не учитывает ежедневные проверки автоматически. Заранее задайте момент анализа или используйте последовательный метод, который позволяет смотреть на результаты по ходу эксперимента.
От теории к практике: как перестать бояться множественных сравнений и начать применять их в работе
На словах все понятно: выбрать гипотезы, задать уровень ошибки, применить поправку. В работе сразу появляются вопросы: какие проверки объединить, хватит ли данных, можно ли запускать новый вариант? Практика помогает научиться отвечать на них.
Почему симулятор A/B-тестов — лучший способ набить шишки безопасно
Разобраться в формулах — первый шаг. Чтобы уверенно применять их в работе, нужно самому спланировать эксперимент, проверить данные и решить, стоит ли запускать изменение. В «Симуляторе A/B-тестов» вы пройдете этот путь на практических заданиях.
На протяжении курса вы работаете с одним продуктом. Появляются новые данные, меняется контекст, а вы принимаете решения и видите их последствия. Это помогает понять, как связаны этапы эксперимента и как ошибка на одном из них влияет на итоговый вывод.
Вы будете проводить A/B-тесты в Jupyter, выбирать метрики, рассчитывать выборку, проверять баланс групп и применять поправки на множественные сравнения. После каждого задания — сразу получать подробную обратную связь, чтобы разобраться в ошибках и двигаться дальше в своем темпе.
Курс рассчитан на аналитиков и продакт-менеджеров, которые уже работают с данными и знают Python. По итогам вы освоите полный цикл A/B-тестирования, сможете оформить полученный опыт в портфолио и получите сертификаты на русском и английском языках.
Заключение
Множественные тесты помогают сравнивать варианты и находить полезные изменения. Но чем больше проверок, тем легче принять случайность за результат. Поэтому заранее решите, что считать успехом, какие гипотезы проверять и как контролировать ошибки.
Бонферрони и Холм контролируют риск хотя бы одной ложной находки, а BH — среднюю долю ложных находок среди значимых результатов. Выбирайте метод под цель эксперимента.
