Выбор базы данных: SQL vs NoSQL vs NewSQL — что и когда использовать
При проектировании системы нужно решить, как она будет хранить данные, обрабатывать запросы и продолжать работу при сбоях. Эти вопросы связаны: выбранное хранилище влияет на устройство приложения, способы масштабирования и гарантии, которые продукт может дать пользователям.
Содержание
- Почему выбор базы данных — это архитектурное решение, а не техническая деталь
- SQL: реляционная модель и транзакции
- NoSQL: разные модели для разных задач
- Операционные запросы и аналитика: почему это разные нагрузки
- NewSQL и Distributed SQL: распределенные транзакции и их цена
- SQL vs NoSQL vs NewSQL: сравнение по ключевым критериям
- Как выбрать базу данных: пошаговый алгоритм
- Полиглотное хранение: когда одной базы становится мало
- Типичные ошибки при выборе базы данных
- Как научиться проектировать систему целиком
- Заключение
Поэтому знание основных видов баз данных — важная часть системного дизайна. Оно помогает сравнивать решения и объяснять свой выбор: почему здесь подходит реляционная модель, для какой задачи понадобится специализированное хранилище и когда оправдана распределенная SQL-система.
В статье разберем SQL, NoSQL и NewSQL, их возможности и ограничения. Затем сравним подходы и составим алгоритм, который поможет выбрать БД под требования продукта.
Почему выбор базы данных — это архитектурное решение, а не техническая деталь
Она определяет, как описывать, связывать, изменять и восстанавливать информацию. Это влияет на устройство приложения и работу команды. Поэтому важно понимать и то, какие базы данных бывают, и то, какие операции должна выполнять ваша система.
К примеру, в магазине начинается распродажа: покупатели ищут товары и оформляют заказы, аналитики считают выручку. Для пользователя это один сайт. Для системы — разные задачи: найти подходящий товар, не продать последнюю вещь двум людям и собрать отчет, не замедлив покупки.
На старте для этого может хватить одной базы. Потребность в дополнительных хранилищах возникает, когда появляются требования, которые существующее решение уже не выполняет с приемлемыми затратами. Сам по себе рост каталога еще не означает, что пора переходить на NoSQL.
Как ошибка на старте влияет на разработку и стоимость продукта
Проблемы появляются, если при выборе БД и проектировании учитывали только первые функции продукта. Новые задачи приходится подстраивать под существующую модель: добавлять обходные решения, дублировать данные и усложнять код. В результате даже небольшие изменения требуют больше времени.
Допустим, заказы хранят внутри документов покупателей. Такая модель удобна для личного кабинета: вместе с профилем можно получить историю покупок. Но менеджерам нужно искать заказы по товарам и статусам, а службе доставки — обновлять каждый заказ отдельно. Если эти операции не предусмотрели, придется пересмотреть структуру документов, индексы и запросы. Возможно, заказы будет удобнее выделить в самостоятельные записи.
Исправить модель до запуска обычно проще: данных мало, а приложение еще меняется. В работающем продукте нужно перенести накопленные записи, переписать запросы, проверить результаты и сохранить доступность сервиса. Иногда на время перехода приходится поддерживать старую и новую модели одновременно. Команда тратит время на миграцию, выпуск новых функций откладывается, а расходы на разработку и инфраструктуру растут.
Избыточная архитектура создает похожую проблему. Если добавить несколько хранилищ на будущее, для каждого понадобятся настройка, мониторинг, резервное копирование и обновления. Между ними придется наладить передачу данных и обработку сбоев. Поэтому на старте полезно выбрать самое простое решение, которое выполняет известные требования, и определить, при каких изменениях нагрузки или функций его потребуется пересмотреть.
Критерии выбора: данные, запросы, масштаб и гарантии
До сравнения технологий стоит описать:
- Данные.
Какие сущности существуют, как связаны и какие правила нельзя нарушать. - Запросы.
Что система читает и меняет чаще всего: одну запись по ключу, документ целиком, цепочку связей или миллионы строк для отчета. - Нагрузку.
Сколько операций ожидается в обычное время и на пике, сколько данных накопится, какие задержки допустимы. - Гарантии.
Какие изменения должны выполняться вместе, где допустимы устаревшие данные, что происходит при отказах. - Эксплуатацию.
Кто будет обновлять систему, следить за ней, восстанавливать данные и оплачивать инфраструктуру.
Так можно сравнивать типы баз данных через проверяемые условия. Например, 99% запросов карточки должны завершаться быстрее установленного порога при заданной нагрузке.
SQL, NoSQL и NewSQL
Такая классификация баз данных помогает разобраться в основных подходах, но важно учитывать, что их выделяют по разным признакам, а возможности во многом пересекаются.
SQL — язык запросов. Под SQL-базами обычно понимают реляционные СУБД: PostgreSQL, MySQL, SQL Server, Oracle Database. Но SQL используют и аналитические, и распределенные системы.
NoSQL объединяет нереляционные подходы: документы, пары «ключ — значение», графы. Одинаковой архитектуры и гарантий у них нет.
NewSQL объединяет системы, сочетающие реляционную модель, SQL и транзакции с масштабированием транзакционной нагрузки. Здесь рассмотрим распределенные SQL-СУБД, например CockroachDB. NewSQL и Distributed SQL пересекаются, но не являются строгими аналогами.
Разбираясь, какие вообще базы данных существуют, отдельно изучайте модели и гарантии.
SQL: реляционная модель и транзакции
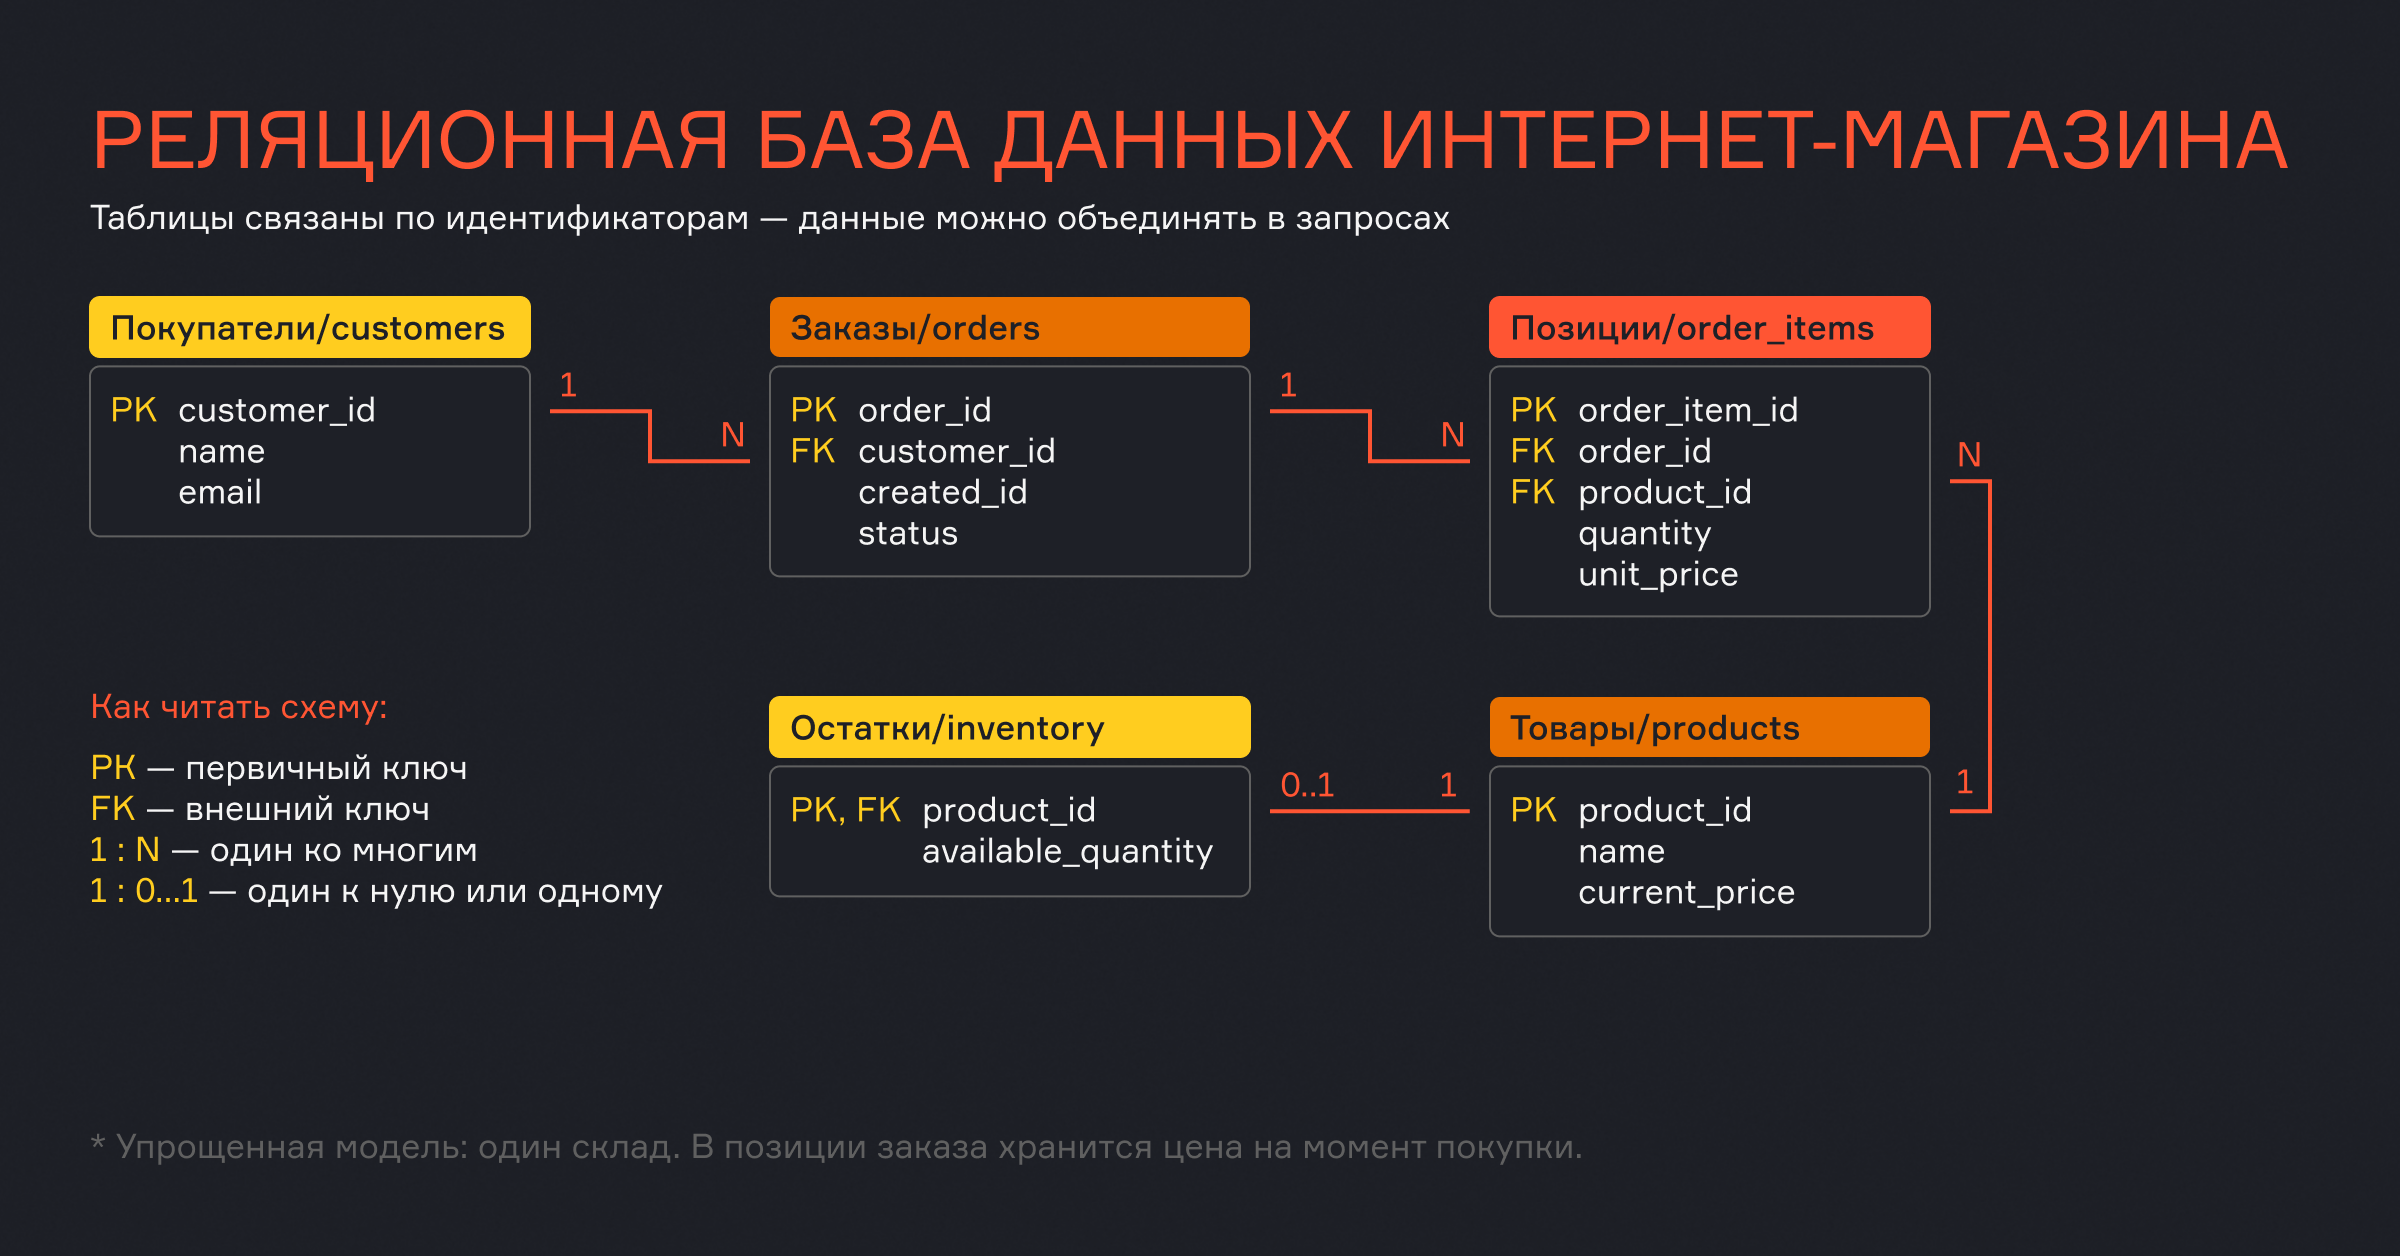
Реляционные хранилища данных хорошо подходят для задач, в которых нужно хранить сведения о разных сущностях и поддерживать связи между ними. В интернет-магазине заказ связан с покупателем, каждая позиция заказа — с конкретным товаром, а остатки показывают доступное количество товара на складе. Модель позволяет описать эти связи и использовать их в запросах. Например, получить состав заказа или историю покупок клиента.
Что такое реляционная модель: таблицы, ключи и связи
Такая база представляет данные в виде отношений, которые обычно описывают таблицами. Строка соответствует записи, столбец — атрибуту. Первичный ключ идентифицирует запись, внешний позволяет контролировать ссылки на другие записи.
Заказ ссылается на покупателя, а позиции связывают его с товарами и фиксируют количество и цену покупки. Последующее изменение каталога не должно переписывать историю продаж.
Для первого знакомства наиболее точным аналогом реляционной базы данных может служить набор связанных таблиц с правилами заполнения. Но СУБД также управляет конкурентным доступом и транзакциями, поэтому аналогия с электронной таблицей ограничена.
JOIN позволяет объединять таблицы: например, заказы и позиции для расчета продаж. Можно задавать новые вопросы, не создавая отдельную копию данных под каждый запрос.
ACID-транзакции: какие гарантии нужны заказам и остаткам
При покупке последнего товара в магазине нужно создать заказ и зарезервировать остаток. Если в одной БД выполнится только половина действий, данные окажутся некорректными.
Транзакция объединяет изменения в одну операцию. ACID описывает четыре ее свойства:
- Atomicity — атомарность. Изменения транзакции применяются целиком либо не применяются.
- Consistency — согласованность. Транзакция сохраняет заданные правила целостности. Например, объявленные ограничения не позволяют записать недопустимое значение.
- Isolation — изоляция. Правила определяют, как параллельные транзакции видят изменения друг друга.
- Durability — долговечность. После успешной фиксации изменения сохраняются в рамках гарантий системы и ее настроек.
ACID не гарантирует правильную бизнес-логику. Если обработчики независимо читают и обновляют остаток, обертки в транзакцию может быть недостаточно. Нужны корректный способ обновления, ограничения и подходящий уровень изоляции. Например, при Serializable в PostgreSQL приложение должно повторять транзакции после ошибок сериализации.
Транзакция в БД не распространяется на внешний платежный сервис, т.е. сохранение заказа и списание денег через его API не становятся одной атомарной операцией. Например, платеж может пройти, а обновление статуса заказа — завершиться ошибкой. Приложение должно уметь проверить результат платежа, безопасно повторить запрос без повторного списания и привести статус заказа в соответствие с фактической оплатой.
Сильные стороны SQL-хранилищ
Реляционная модель позволяет контролировать обязательные поля, уникальность, диапазоны и связи. Ошибки выявляются до того, как попадут в отчеты.
SQL удобен для объединений и агрегаций, особенно когда запросы развиваются вместе с продуктом: от списка заказов до анализа повторных покупок.
Структура не запрещает гибкость: PostgreSQL поддерживает JSONB и его индексирование. Общие поля товара можно хранить в столбцах, изменяемые характеристики — в JSONB. Правила заполнения все равно нужны.
Когда выбирать SQL
Реляционная СУБД — кандидат для заказов, бронирований и учетных систем, где важны связанные изменения и разнообразные запросы.
Решая, какую базу данных выбрать для сайта, начните с его функций. Магазину может хватить PostgreSQL или MySQL, а статическому сайту собственная БД может не понадобиться.
Обсуждая виды SQL-баз данных, различайте продукты и архитектуры. Общий язык не делает их взаимозаменяемыми: проверьте функции, ограничения среды и опыт команды.
Масштабировать реляционную БД можно несколькими способами. Один — увеличить ресурсы сервера: добавить процессорные ядра, оперативную память или более быстрые диски. Другой — распределить нагрузку между серверами. Реплики позволяют перенести часть запросов на чтение на копии базы, а шардирование — разделить данные между узлами.
При шардировании нужно продумать, как распределять записи и выполнять операции, затрагивающие несколько узлов. Особенно это важно для транзакций, которые должны согласованно изменить данные в разных частях системы. Партиционирование решает другую задачу: оно делит таблицу на части, например по датам. Если эти части остаются на одном сервере, распределенного кластера не возникает.
NoSQL: разные модели для разных задач
NoSQL расшифровывают как Not Only SQL. Такая трактовка подчеркивает, что работа с данными не ограничивается реляционными таблицами и SQL-запросами: в зависимости от задачи можно использовать документы, пары «ключ — значение», графы и другие модели. Чтобы понять, какие виды БД бывают внутри этой группы, рассмотрим их модели и операции.
BASE: когда данные могут обновляться с задержкой
В распределенной системе данные могут храниться в нескольких копиях на разных серверах. Когда информация меняется, обновление нужно передать остальным копиям. Пока оно распространяется, пользователи могут получать немного разные результаты.
Например, один покупатель видит у товара 120 просмотров, а другой — уже 121. Обычно такая разница не мешает пользоваться магазином. Система может продолжать отвечать на запросы, не дожидаясь, пока все копии обновятся.
Этот подход описывают сокращением BASE:
- Basically Available — базовая доступность. Система стремится продолжать обслуживать запросы, даже если часть компонентов недоступна.
- Soft State — изменяемое состояние. Данные на отдельном сервере могут обновиться при синхронизации с другими копиями, без нового действия пользователя.
- Eventually Consistent — согласованность в конечном счете. Если новые изменения перестанут поступать, а обмен между серверами будет работать, копии со временем придут к одному состоянию.
Последнее свойство не задает конкретный срок обновления: допустимую задержку нужно определить для задачи и проверить на практике.
Для счетчика просмотров небольшое отставание обычно приемлемо. Для продажи последнего экземпляра товара уже нет: система должна исключить ситуацию, когда два покупателя успешно резервируют одну вещь. Поэтому требования к актуальности и согласованности данных определяют отдельно для каждой операции.
При этом NoSQL не означает обязательного отказа от транзакций или строгих гарантий. Например, MongoDB поддерживает ACID-транзакции между несколькими документами. Возможности и ограничения нужно проверять у конкретной СУБД с учетом ее настроек.
Документоориентированные БД: MongoDB
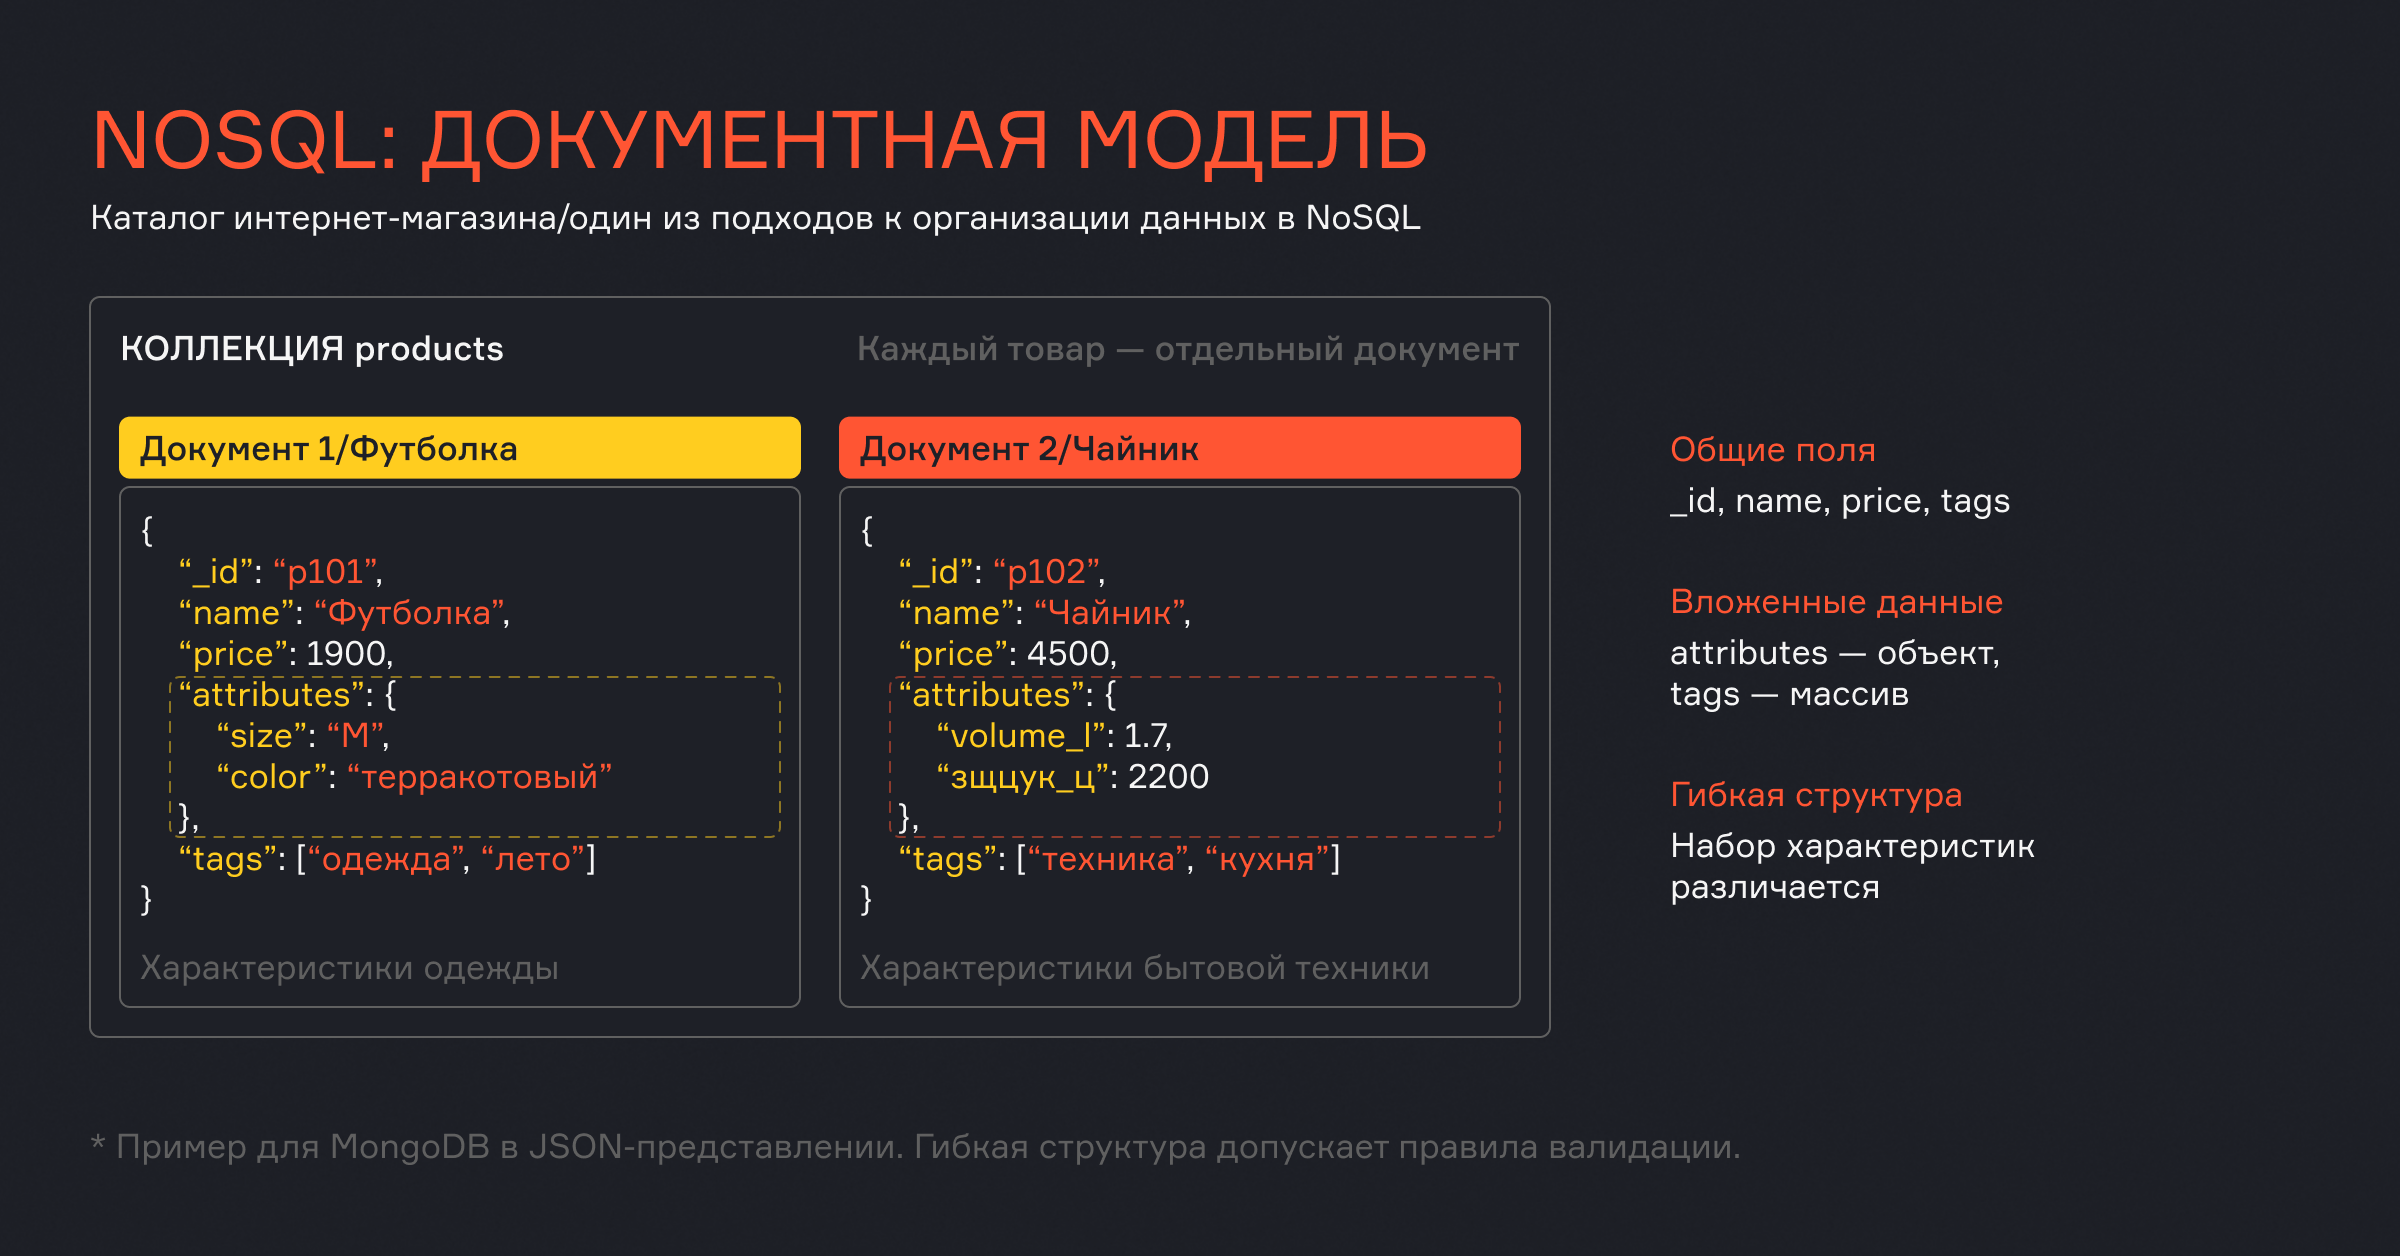
В документной базе данные хранятся в виде записей, которые могут содержать обычные поля, вложенные объекты и списки. Например, в одном документе можно собрать название товара, цену, характеристики и ссылки на изображения. Приложению удобно получать такую карточку целиком.
При этом структура карточек может различаться. В MongoDB такие документы можно хранить в одной коллекции. Гибкость не означает отсутствие контроля: правила валидации позволяют задать обязательные поля и допустимые типы значений. Например, проверить, что цена указана числом.
Документная модель хорошо подходит, когда данные естественно объединяются в относительно самостоятельные объекты, с которыми приложение часто работает целиком. Однако разные характеристики товаров сами по себе еще не требуют MongoDB: их можно хранить и в JSONB-полях PostgreSQL. Выбор зависит от того, как приложение читает и изменяет данные, какие связи между ними нужны и какие операции должны выполняться в одной транзакции.
Key-value-хранилища и кэши: Redis, Memcached
Key-value-хранилище организует данные в виде пар «ключ — значение». Приложение обращается по известному ключу и получает соответствующее значение. Например, ключом может быть идентификатор товара, а значением — готовые данные его карточки.
Такие хранилища часто используют как кэш — временное хранилище для быстрого повторного доступа к данным. Приложение один раз получает карточку из основной базы и сохраняет ее в кэше. При следующих обращениях оно может вернуть готовую копию, сократив время ответа и нагрузку на базу.
Заранее нужно определить, сколько хранить копию и как обновлять ее при изменении товара. Если записи в кэше нет, приложение обращается к основному источнику. На случай недоступности самого кэша тоже нужен план: например, чтение из основной БД с ограничением нагрузки.
Для кэширования часто используют Memcached и Redis. Memcached хранит данные в оперативной памяти и предназначен прежде всего для кэша. Redis поддерживает более разнообразные структуры данных, поэтому подходит также для задач со счетчиками, списками и рейтингами. Кроме того, Redis позволяет сохранять данные на диск: RDB создает снимки состояния, а AOF ведет журнал операций записи. Возможность восстановить последние изменения после сбоя зависит от выбранного режима и настроек.
Wide-column-хранилища: Cassandra
Cassandra — кандидат для интенсивной распределенной записи с понятными сценариями чтения. Модель строят под запросы, выбирая ключ партиции и порядок записей внутри нее.
Для измерений устройства ключ может включать устройство и временной интервал, ограничивая размер партиций. Неудачный ключ создает перегруженные участки даже в большом кластере.
Для разных запросов может потребоваться несколько представлений данных. Переход от событий одного устройства к поиску по произвольному признаку не обязательно будет простой заменой фильтра.
Выбор оправдывают требования к распределенной записи и подходящие запросы. Условия «много данных» недостаточно.
Графовые БД: Neo4j
В графовой модели сущности — узлы, отношения — связи. Neo4j позволяет задавать свойства обоим и искать пути и сочетания отношений.
В магазине граф может помочь найти подозрительные связи: аккаунты используют общие устройства, адреса и платежные инструменты.
Связи есть и в реляционной модели. Графовая БД оправдана, если обходы составляют существенную нагрузку и выигрыш подтвержден. Она не всегда быстрее JOIN.
Поисковые движки: Elasticsearch
Поиск товара должен учитывать ожидания покупателя: он может ошибиться в слове или использовать синоним. Это сложнее получения записи по ID.
Elasticsearch можно использовать как поисковый индекс поверх основного каталога. Изменение становится доступно поиску после обновления индекса, не обязательно сразу после записи.
При оформлении заказа цену и наличие проверяют в источнике истины. Для небольшого проекта сначала оцените поиск основной СУБД: отдельный движок нужен под конкретные требования.
Временные ряды: InfluxDB и Prometheus
Временные ряды — измерения, связанные со временем: температура, загрузка процессора, задержки сервиса. Для них нужны запросы по интервалам, агрегации и правила хранения.
Здесь встречаются специализированные БД, например InfluxDB, и системы мониторинга, например Prometheus. Prometheus предназначен для мониторинга и оповещений, а не точного биллинга или журнала покупок.
Мониторинг покажет рост ошибок. Историю заказов хранит система с гарантиями для бизнес-данных: временная метка не делает любую запись задачей TSDB.
Когда выбирать NoSQL
Его стоит рассматривать, когда модель конкретного хранилища хорошо соответствует работе приложения. Документная база может быть удобна для карточек со вложенными данными, key-value — для быстрого получения значения по известному ключу, графовая — для поиска цепочек связей между сущностями.
При этом само название NoSQL не гарантирует высокую скорость или простое масштабирование. Сначала определите, какие операции выполняет приложение, как часто они поступают, сколько данных затрагивают и какое время ответа допустимо. Отдельно уточните, где можно показывать немного устаревшие сведения, а где нужны транзакции и строгие гарантии.
После этого сравните конкретные СУБД на характерных запросах и оцените сложность их сопровождения. Выбор будет обоснованным, если преимущества системы решают вашу задачу, а ее ограничения приемлемы для продукта и команды.
Операционные запросы и аналитика: почему это разные нагрузки
В обзоре разновидностей БД стоит разделять OLTP и OLAP.
OLTP — текущие операции: создать заказ, изменить адрес. Обычно запрос затрагивает немного записей, но запросов много и они выполняются параллельно.
OLAP — аналитика: выручка по категориям за год, сравнение регионов. Один запрос может обрабатывать большие массивы и сложные агрегации.
Колоночные СУБД, например ClickHouse, эффективно читают нужные столбцы и агрегируют их. ClickHouse использует SQL. Его не следует объединять с Cassandra из-за сходства слов columnar и wide-column: это разные подходы и задачи.
Сначала отчеты можно строить в основной базе. Если аналитика мешает заказам, рассмотрите отдельное хранилище. Заранее определите допустимое отставание отчетов и проверку полноты загрузки.
NewSQL и Distributed SQL: распределенные транзакции и их цена
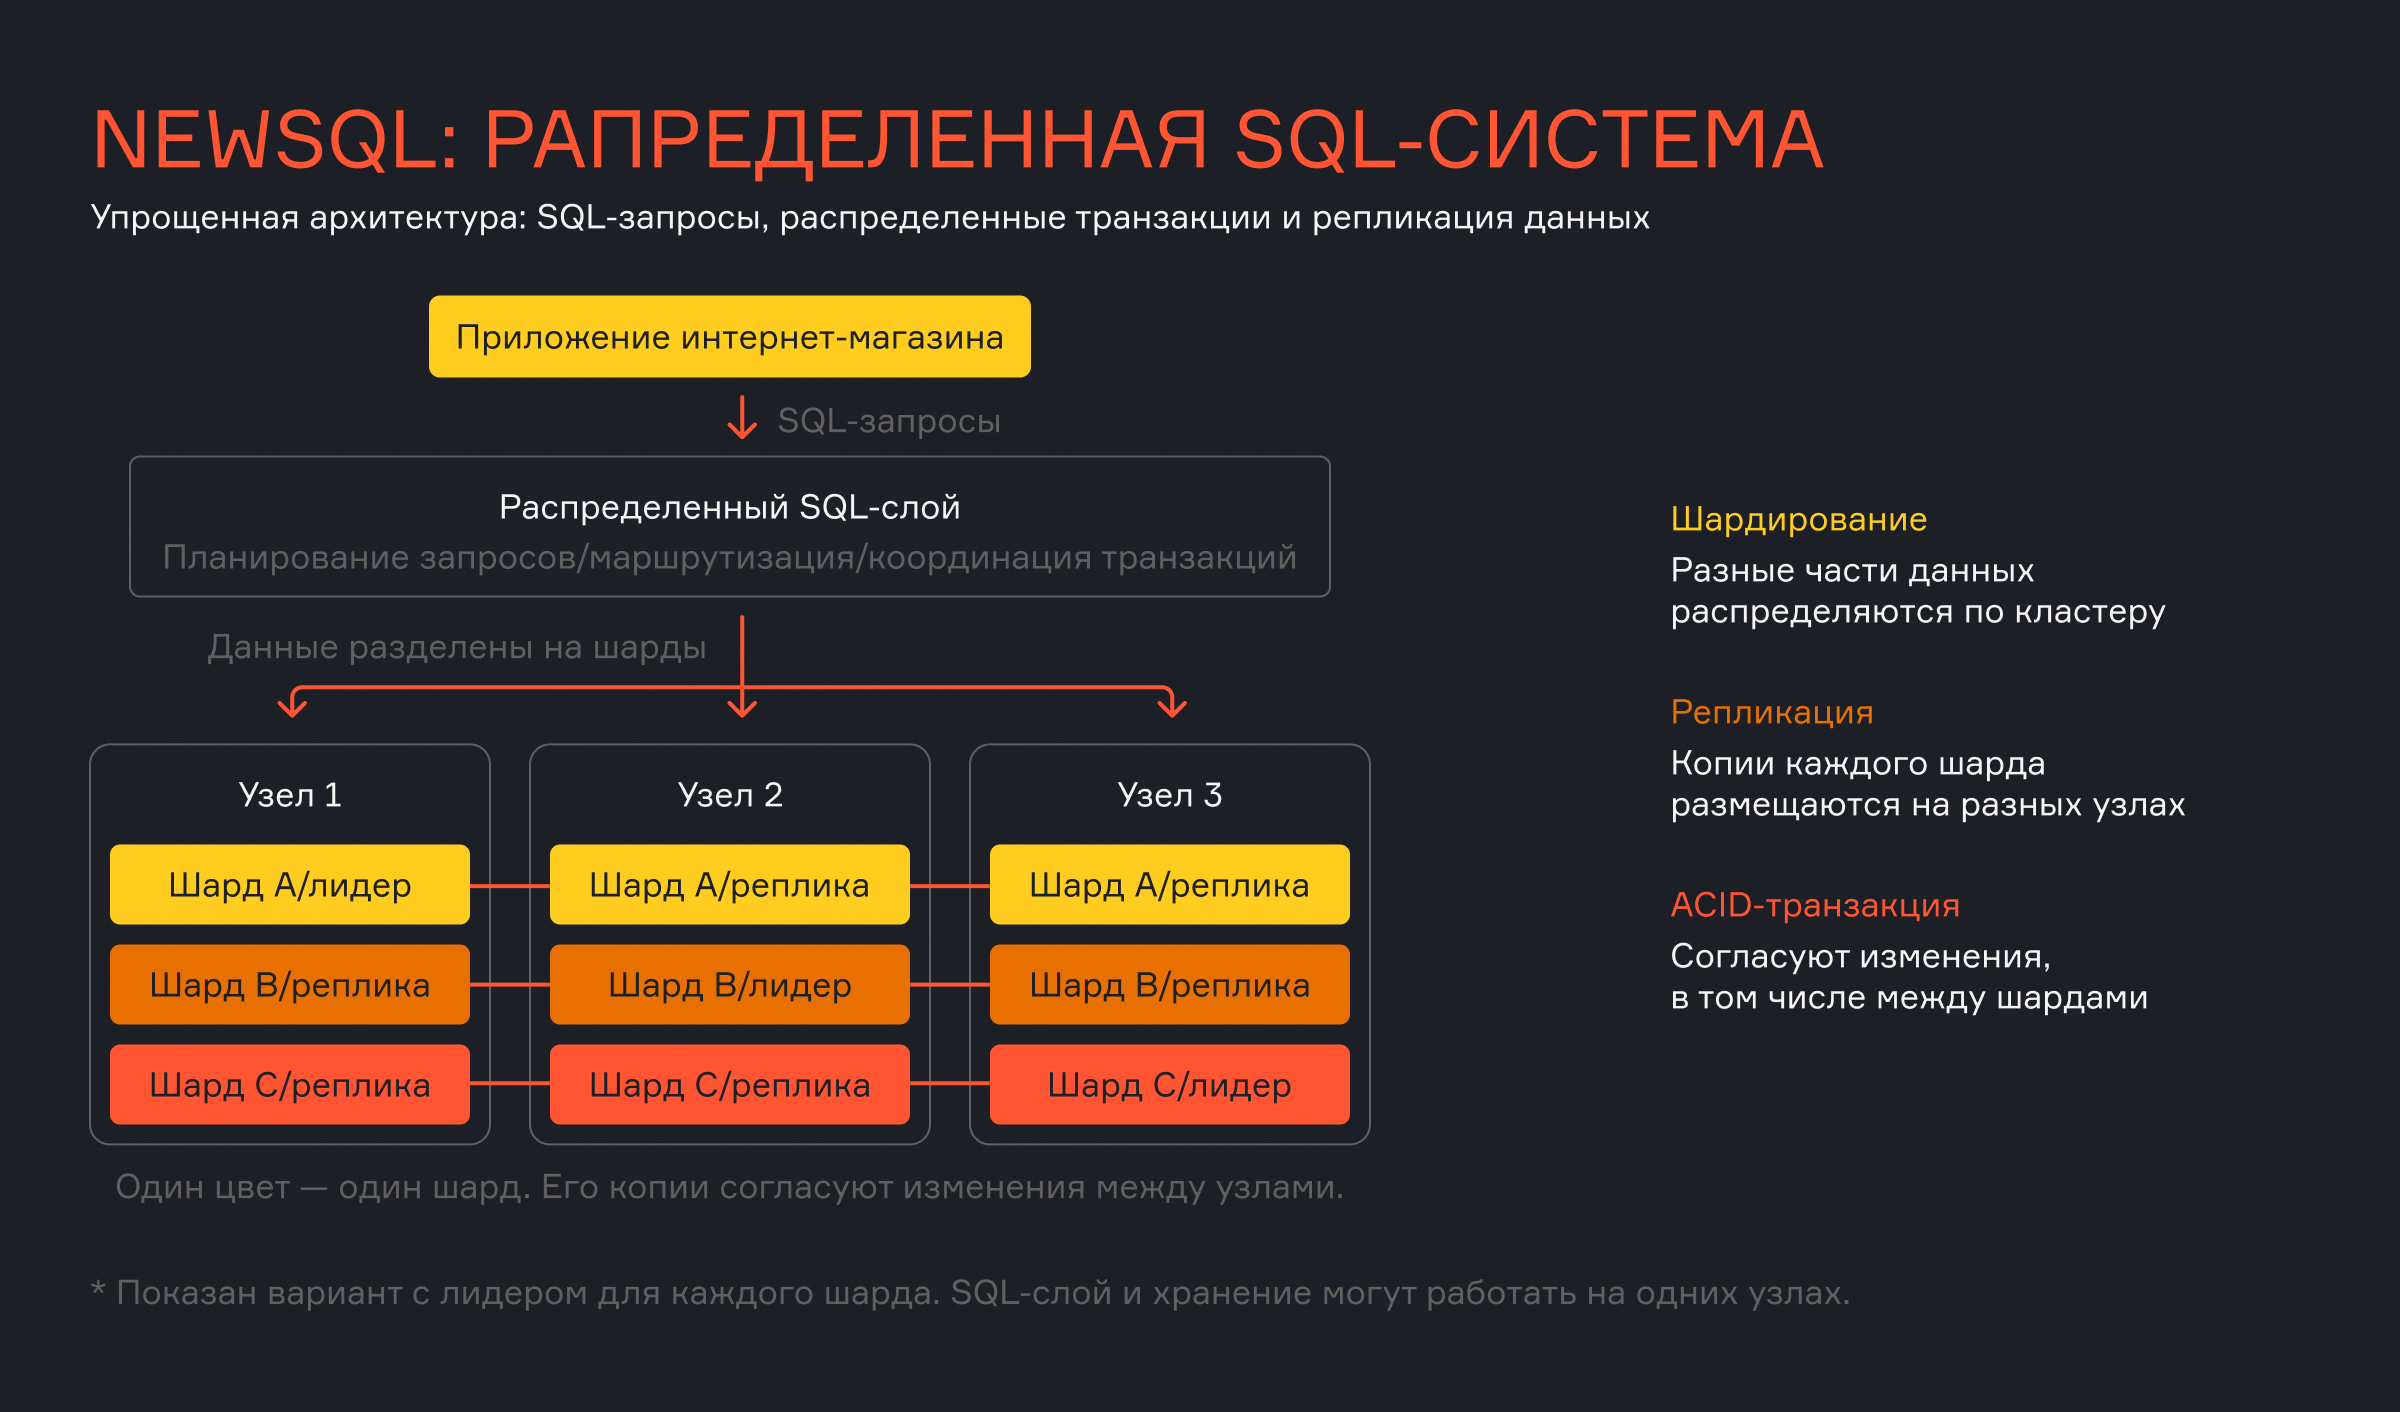
Иногда система одновременно требует SQL, транзакций между связанными записями и распределения нагрузки по нескольким узлам. Здесь имеет смысл рассматривать распределенные SQL-СУБД.
Какую проблему они решают
Магазин стал международной платформой: данные нужно распределять, а собственное шардирование и согласование транзакций становятся слишком сложными.
Distributed SQL переносит эту работу в СУБД. CockroachDB распределяет данные по диапазонам, реплицирует их и использует Raft для согласования реплик. Сверху работает SQL-слой.
Горизонтальное масштабирование, ACID и SQL: где компромисс
Добавление узлов не ускоряет любой запрос. Транзакция между частями кластера требует координации, а географически удаленные реплики добавляют сетевые задержки.
Важно, какие данные меняются вместе, где находятся и какие транзакции конфликтуют. SQL-совместимость тоже не гарантирует перенос без изменений: функции и поведение запросов могут отличаться.
Когда выбирать NewSQL
NewSQL стоит рассматривать, когда нагрузку на запись нужно распределить между несколькими узлами, сохранив SQL и возможность выполнять транзакции над связанными данными. Например, система обрабатывает множество заказов, а некоторые операции затрагивают данные в разных частях кластера. Дополнительными причинами могут стать требования к размещению данных в нескольких регионах и продолжению работы при отказе отдельных узлов.
При этом важно оценить, готова ли команда сопровождать распределенную систему: следить за состоянием кластера, разбирать задержки и конфликты транзакций, проверять восстановление после сбоев.
Сама по себе высокая посещаемость сайта еще не означает, что ему нужна NewSQL. Сначала выясните, что ограничивает производительность. Возможно, достаточно оптимизировать запросы, добавить индексы, увеличить ресурсы сервера или перенести часть чтений на реплики. Если существующая БД выполняет требования к нагрузке и надежности, переход на распределенную SQL-систему может увеличить стоимость и сложность эксплуатации без заметной пользы для продукта.
SQL vs NoSQL vs NewSQL: сравнение по ключевым критериям
Разобрались, какие есть базы данных, теперь сравним их в одной таблице.
| Критерий | Традиционные SQL-СУБД | NoSQL | Distributed SQL в рамках NewSQL |
| Модель | Реляционная; возможны дополнительные типы данных | Документы, ключи и значения, графы и другие модели | Реляционная, с распределенной архитектурой |
| Запросы | SQL, JOIN, агрегации | API и языки конкретных систем; возможности различаются | SQL с особенностями реализации |
| Схема | Обычно явно задана; возможны JSON-поля | От гибких документов до схем с типизированными полями | Обычно явно задана |
| Транзакции | Развитая поддержка; важны уровень изоляции и границы | От атомарности записи до ACID-транзакций | Распределенные транзакции |
| Свежесть чтения | Зависит от режима чтения и репликации | Зависит от продукта и выбранных гарантий | Зависит от режима чтения и реализации |
| Масштабирование | Увеличение ресурсов, реплики, шардирование | Устройство и ограничения сильно различаются | Распределение нагрузки встроено |
| Основной повод выбрать | Связанные бизнес-данные и разнообразные запросы | Подходящая специализированная модель доступа | Транзакционные требования при распределенной записи |
| Что проверить | Запросы, индексы, блокировки, пределы выбранной архитектуры | Ограничения модели, гарантии, ключи распределения | Задержки координации, локальность, совместимость, стоимость |
Как выбрать базу данных: пошаговый алгоритм
Зафиксируйте требования и предположения письменно: что подтверждено, а что еще нужно проверить.
1. Определите модель данных
Выпишите сущности, связи и правила. Что меняется вместе? Какие записи самостоятельны? Где нужна уникальность? Для магазина начните с покупателя, заказа, товара и резерва.
2. Проанализируйте паттерны доступа
Перечислите операции: получить заказ, показать покупки, найти товар, собрать отчет. Укажите фильтры, сортировку, число результатов и частоту.
Вместо «каталог большой» опишите: карточку читают целиком, поиск идет по характеристикам, обновления — пакетные. Это поможет сравнить типы баз данных.
3. Определите требования к транзакциям и свежести
Установите допустимое поведение: можно ли показать старое описание, насколько отстает отчет, какие действия должны выполняться вместе?
Для остатков задайте инвариант: подтвержденные резервы не превышают доступное количество. Проверьте его при параллельных запросах.
4. Оцените рост и масштаб
Оцените чтение, запись, размеры и сроки хранения. Средняя нагрузка скрывает распродажи, импорты и ночные расчеты.
Полезный объем приблизительно равен размеру записи × числу записей в сутки × сроку хранения в сутках. Добавьте индексы, реплики и запас. Отдельно оцените пропускную способность: место на диске не гарантирует своевременного ответа.
5. Учтите эксплуатацию и зрелость
Проверьте резервное копирование, мониторинг, обновление и восстановление. Кто разбирает инциденты и какие знания есть у команды?
Определите RPO — допустимую потерю данных во времени — и RTO — время восстановления. Реплика не заменяет бэкап: ошибочное удаление может распространиться на нее.
Учтите серверы, лицензии, трафик, копии и труд команды. Управляемый сервис снимает часть инфраструктурных задач, но не ответственность за корректность приложения.
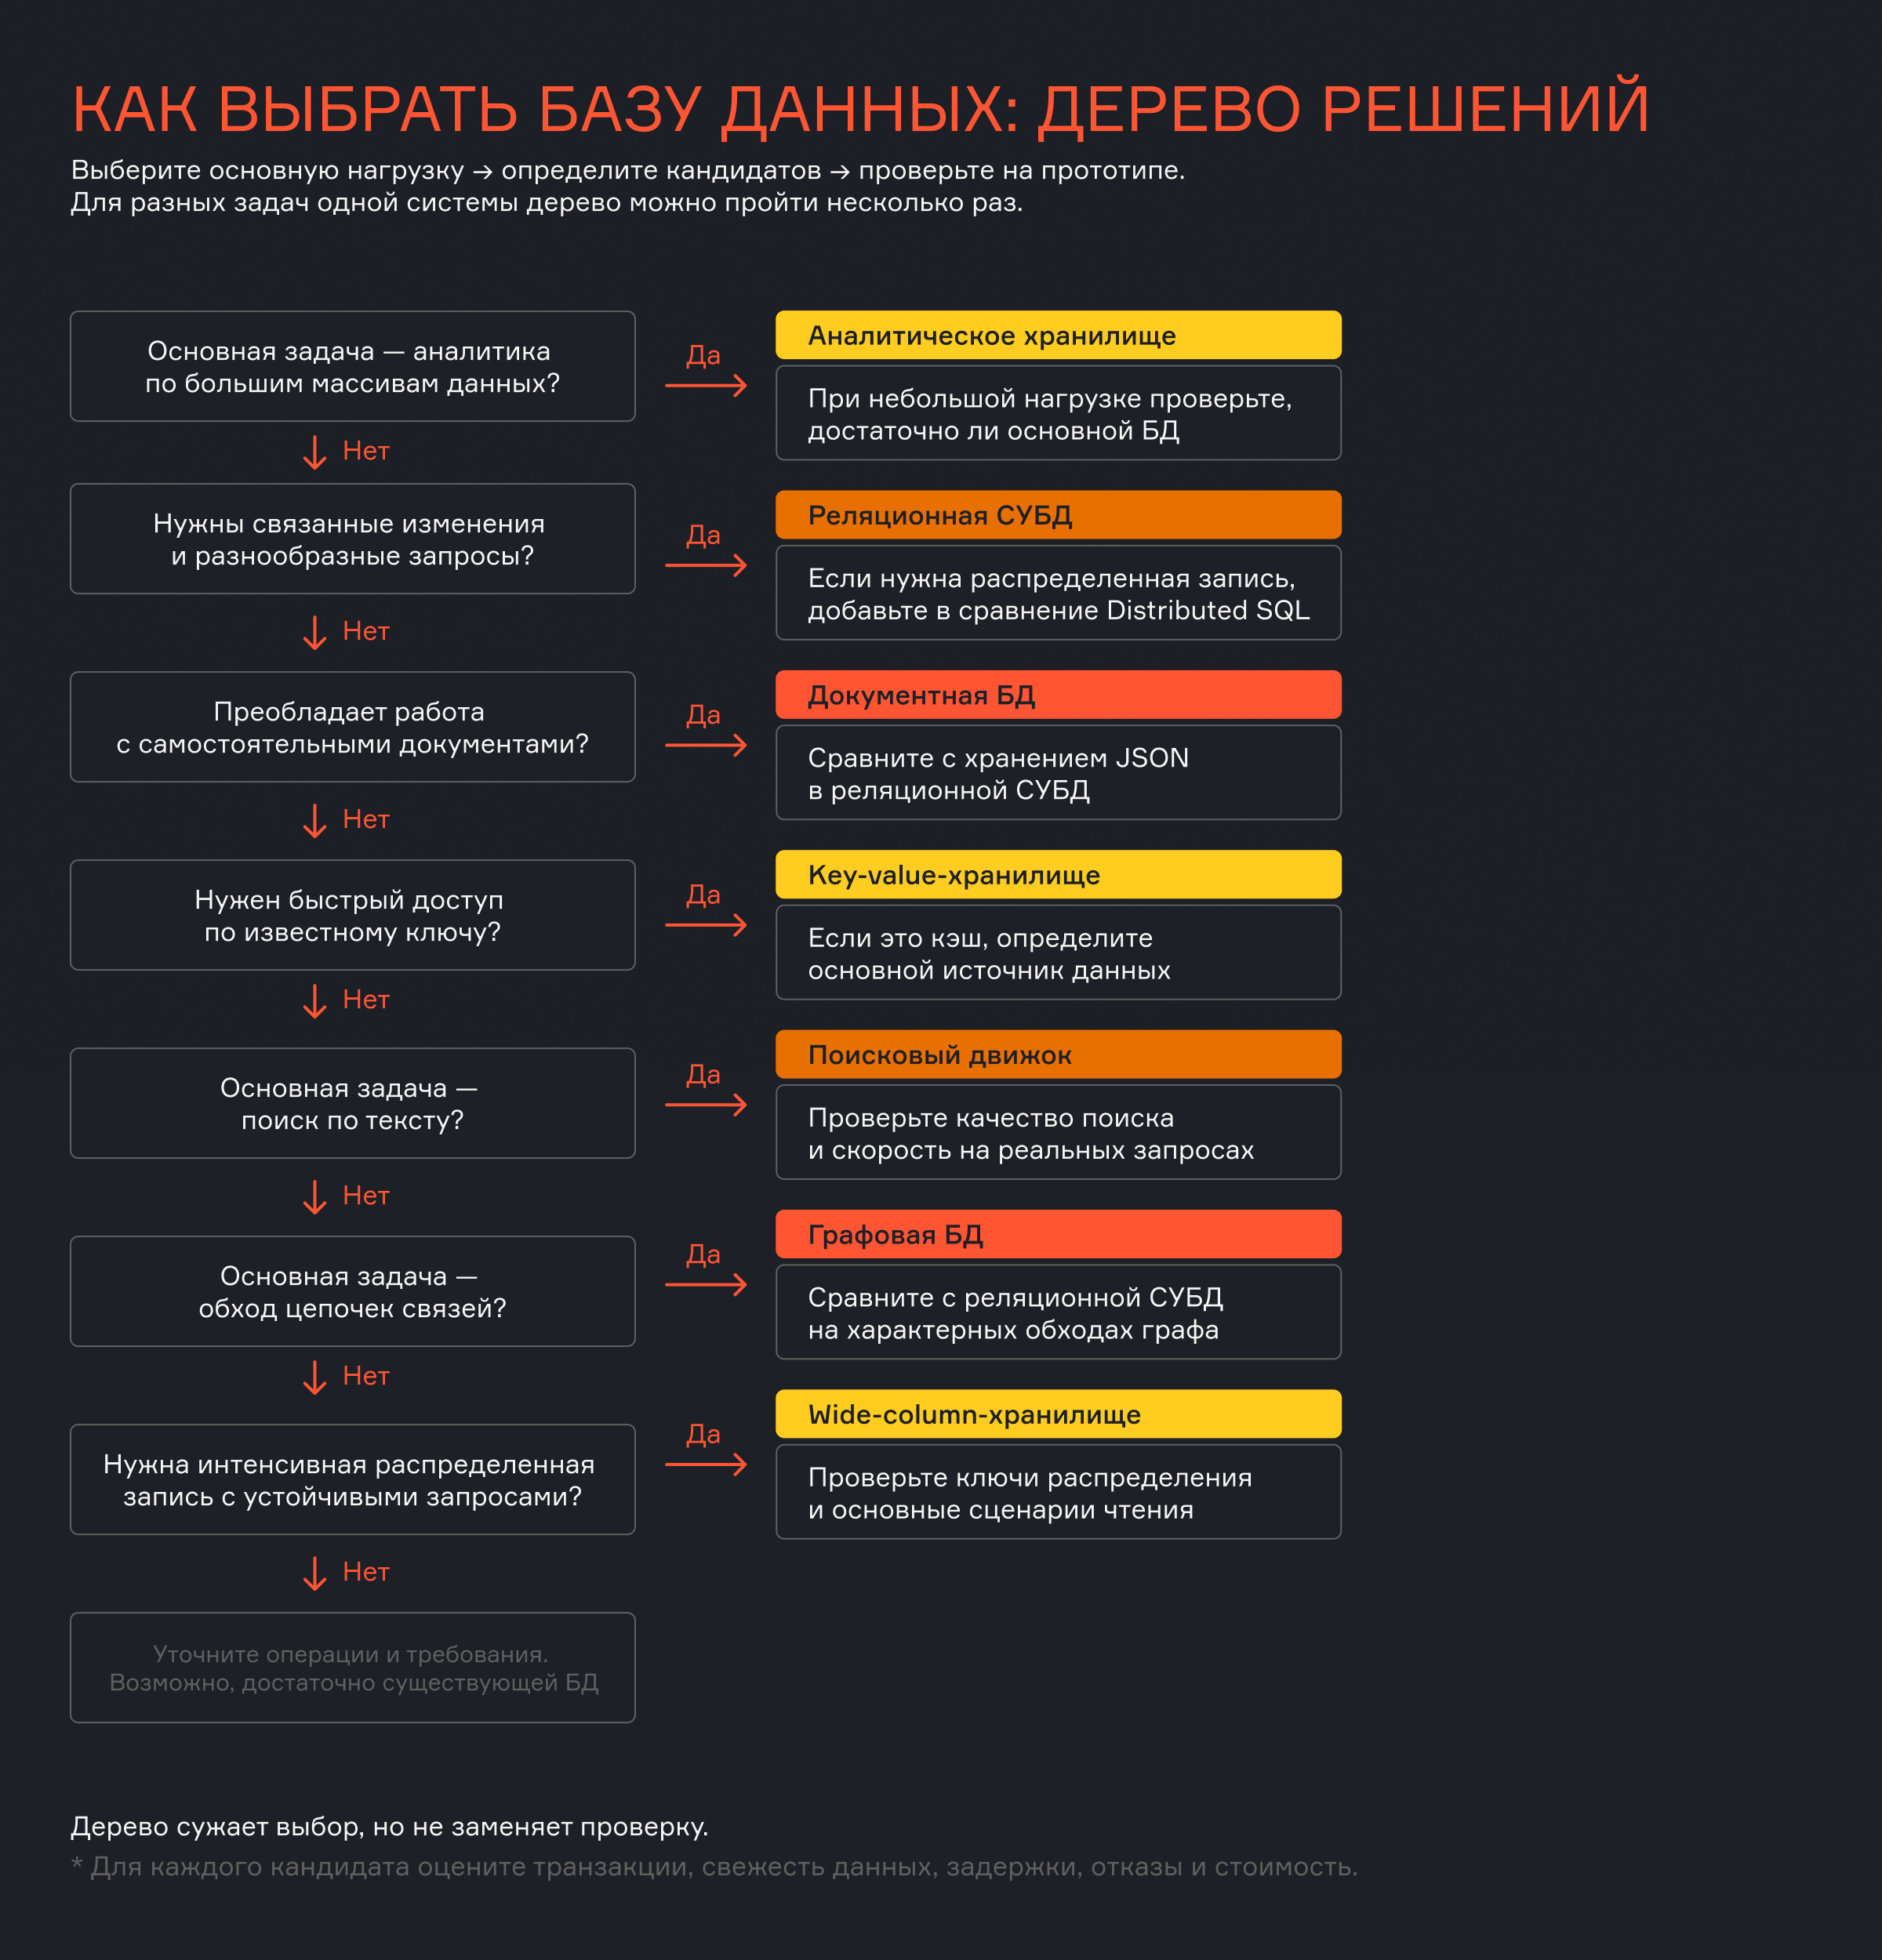
6. Пройдите дерево решений
Используйте его как способ сузить выбор.
Для мониторинга рассматривайте специальные инструменты. Попадание в несколько веток — повод разделить нагрузки, а не внедрить все технологии.
7. Проверьте кандидатов на прототипе
На репрезентативных данных воспроизведите параллельную запись, пики и неравномерную популярность товаров. Измерьте p95/p99 — пороги, в которые укладываются 95% и 99% ответов.
Проверьте отказ узла и восстановление. Сравнивайте при одинаковых требованиях к сохранности и свежести: слабые гарантии могут создавать обманчивое преимущество в скорости.
Запишите требования, измерения, выбор и условия пересмотра: например, новое требование к географии записи или нарушение целевой задержки после оптимизации.
Полиглотное хранение: когда одной базы становится мало
Полиглотное хранение — несколько технологий для разных задач: основная БД для заказов, Elasticsearch для поиска, Redis для кэша, отдельное хранилище для аналитики.
Каждая система должна решать подтвержденную проблему. Вместе с ней появляются доставка изменений, контроль отставания и восстановление данных.
Определите источник истины. Если каталог хранится в основной БД, поисковый индекс должен быть восстановим из нее. Оформление заказа проверяет актуальные условия в источнике.
Независимая запись в две базы может завершиться частично. Один из подходов — transactional outbox: бизнес-изменение и событие сохраняют в одной локальной транзакции, затем отдельный процесс доставляет событие. Получатель обрабатывает повторы. Другой вариант — CDC, чтение потока изменений источника.
Добавляйте хранилища с понятной целью, правилами синхронизации и планом восстановления.
Типичные ошибки при выборе базы данных
- Выбирать по популярности. Нагрузка, бюджет и команда другой компании могут отличаться от ваших.
- Считать NoSQL отсутствием схемы. Код все равно ожидает определенную структуру; ее изменения требуют правил.
- Доверять одной транзакции. Нужно отдельно продумать бизнес-инварианты, конкуренцию и повторы запросов.
- Менять СУБД до диагностики. Причиной задержек могут быть индексы, блокировки или лишние обращения.
- Масштабировать заранее. Сложное решение требует измеримой причины, поскольку добавляет координацию и сценарии отказа.
- Проверять только штатный режим. Быстрый прототип не доказывает возможность восстановиться в допустимое время.
- Добавлять хранилища без источника истины. Заранее определите, где хранится актуальная версия и как разрешать расхождения.
Как научиться проектировать систему целиком
Кэш меняет требования к свежести, очередь — доставку изменений, география — задержки. Выбор БД требует понимания всего пути запроса и последствий отказов.
Выбор БД — один из слоев системного дизайна
В начале статьи мы обозначили три связанные задачи: хранить данные, обрабатывать запросы и продолжать работу при сбоях. Сравнение SQL, NoSQL и NewSQL помогает выбрать хранилище, но дальше нужно определить, как оно будет взаимодействовать с остальными компонентами.
- Какие запросы пойдут в основную БД, какие — в кэш?
- Как изменения попадут в поисковый индекс?
- Что увидит пользователь, если часть системы станет недоступна?
Научиться последовательно разбирать такие вопросы поможет курс «Системный дизайн». Программа охватывает путь от сбора функциональных и нефункциональных требований и оценки нагрузки до высокоуровневого и компонентного проектирования. Отдельное внимание уделяется масштабированию, подсистемам хранения, поиска и аналитики.
Практические задания и финальный проект помогают связать эти решения в целостную архитектуру и обосновать ее устройство: объяснить выбор компонентов, оценить ограничения и продумать поведение при сбоях. Именно такой подход позволяет перейти от знания отдельных технологий к проектированию системы под требования продукта.
Курс рассчитан на специалистов среднего уровня и выше с опытом разработки отдельных компонентов систем. Он подойдет тем, кто хочет систематизировать этот опыт, увереннее обсуждать архитектурные решения с командой и подготовиться к интервью в крупную технологическую компанию.
https://vkvideo.ru/video760719865_456241265
Заключение
Реляционные СУБД удобны для связанных бизнес-данных и разнообразных запросов. NoSQL предлагает специализированные модели для документов, доступа по ключу, графов и других задач. Распределенные SQL-системы помогают сочетать транзакции с распределением данных и нагрузки между узлами.
Эти ориентиры дают отправную точку. Окончательный выбор зависит от операций приложения, необходимых гарантий и возможностей команды. Чем точнее вы описали требования и проверили свои предположения, тем легче будет объяснить решение и понять, когда его пора менять.