Как прокачать SQL до уровня, нужного в работе: оконные функции, CTE и оптимизация
Запрос выполнился без ошибок. Выручка посчитана, категории расставлены по местам, среднее за неделю выглядит правдоподобно. Только в среднее попали семь покупок вместо семи дней, а две категории с одинаковой выручкой получили разные места.
Содержание
База данных выполнила инструкции, но ответила ли она на вопрос бизнеса? Чтобы уверенно работать с SQL, нужно понимать, какие строки участвуют в расчете, как связаны его этапы и что изменится, когда данных станет больше.
Почему базового SQL уже недостаточно
Для начала важно уверенно пользоваться базовыми конструкциями: отбирать строки, соединять таблицы и считать агрегаты. Если нужно освежить эти навыки, в бесплатном «Симуляторе SQL» можно потренироваться на задачах с автоматической проверкой прямо в браузере.
Когда с основами все понятно, следующий шаг — научиться собирать из отдельных операций полноценный расчет. Разберем, какие требования появляются в рабочих задачах и какие инструменты помогают с ними справиться.
От SELECT к сложному анализу — что меняется в работе
«Посчитайте выручку по категориям за месяц» — на первый взгляд, задача на один запрос с SUM и GROUP BY. Но прежде чем его писать, нужно уточнить условия. Учитываем оформленные или только оплаченные заказы? Вычитаем возвраты? Если покупатель оформил заказ в августе, а оплатил в сентябре, в какой месяц попадет сумма? От ответов зависит результат.
Затем нужно определить детализацию, т.е. что означает одна строка исходных данных и будущего отчета. В таблице продаж строкой может быть отдельная товарная позиция. Тогда COUNT(*) посчитает позиции, хотя заказов окажется меньше: в одном заказе бывает несколько товаров. Для отчета по дневной выручке понадобится другая детализация — одна строка на дату и категорию.
После расчета проверьте, соответствует ли ответ условиям задачи. Например, совпадает ли общая выручка с контрольной суммой, не задвоились ли продажи после соединения таблиц, присутствуют ли дни без покупок.
И наконец, оцените время выполнения на рабочем объеме данных. Если отчет должен обновляться каждое утро, запрос должен успевать завершиться к нужному времени. Правильный результат и своевременное обновление — две части одной задачи.
Три кита продвинутого SQL: оконные функции, CTE и оптимизация
Вернемся к отчету магазина. Дневная выручка по категориям уже посчитана. Теперь нужно сравнить ее со вчерашней, определить лидеров продаж и показать сумму с начала месяца.
Оконные функции помогают выполнить эти расчеты, сохранив отдельную строку для каждого дня и категории. Рядом с дневной выручкой появятся значение за предыдущий день, место в рейтинге и накопительная сумма.
CTE позволяют разделить запрос на понятные этапы: сначала отобрать оплаченные позиции, затем посчитать дневные суммы, после — добавить сравнения и рейтинг. Каждый этап можно проверить отдельно, чтобы понять, где возникла ошибка.
Оптимизация помогает выяснить, на что база тратит время. Например, для дневного отчета можно сначала сгруппировать товарные позиции до дня и категории, а затем выполнять оконные расчеты на меньшем наборе. Изменение нужно проверить: сохранился ли результат и сократилось ли время выполнения.
Что вы узнаете из этой статьи
Мы сформируем отчет для интернет-магазина: с дневной выручкой, рейтингом категорий, средним за неделю и накопительной суммой. На небольших таблицах разберем, как добавлять в SQL-запросы оконные функции, покажем типичные ошибки и объединим расчеты в витрину данных — таблицу с готовыми показателями для отчета. Затем посмотрим, как найти лишнюю работу в запросе и проверить, помогли ли изменения его ускорить.
По ходу предложим несколько заданий: предсказать результат, найти ошибку и изменить условия расчета. Их можно разобрать без запуска базы.
Материал рассчитан на тех, кто уже знаком с SELECT, JOIN и GROUP BY. Примеры написаны для PostgreSQL: общие принципы пригодятся и в других СУБД, но синтаксис и особенности выполнения могут отличаться.
Оконные функции
Конструкция OVER (PARTITION BY … ORDER BY …) может выглядеть сложной, пока не разобрать ее по частям. За ней стоят понятные вопросы: какие строки сравниваем, в каком порядке и какие из них включаем в расчет.
Что такое оконные функции и как они работают
Возьмем четыре оплаченные позиции из таблицы sales. Для наглядности покажем только идентификатор позиции, категорию и сумму. Каждая строка соответствует отдельной позиции заказа.
| sale_id | category_id | amount |
| 1 | Книги | 500 |
| 2 | Игры | 1 000 |
| 3 | Книги | 300 |
| 4 | Игры | 2 000 |
Здесь вместо числовых идентификаторов категорий используем названия, чтобы результат было проще читать.
Если нужно узнать общую сумму продаж каждой категории, достаточно группировки:
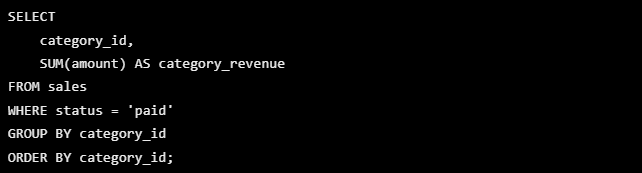
Запрос объединит позиции одной категории и вернет две строки:
| category_id | category_revenue |
| Игры | 3 000 |
| Книги | 800 |
Отдельных позиций в результате больше нет. Для сводного отчета это удобно. Но что делать, если рядом с каждой позицией нужно показать общую сумму ее категории? Добавим к SUM конструкцию OVER:
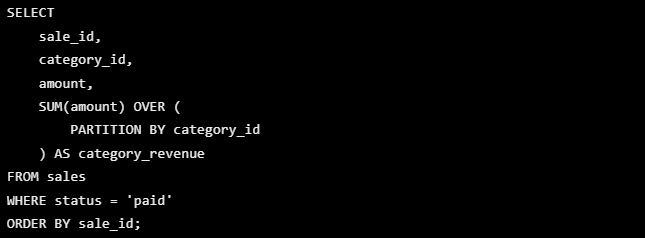
Получим другой результат:
| sale_id | category_id | amount | category_revenue |
| 1 | Книги | 500 | 800 |
| 2 | Игры | 1 000 | 3 000 |
| 3 | Книги | 300 | 800 |
| 4 | Игры | 2 000 | 3 000 |
Суммы категорий те же, но все четыре позиции сохранились. Аналитические оконные функции SQL позволяют добавить к строке результат вычисления по связанному с ней набору строк. В нашем примере таким набором стали оплаченные позиции той же категории.
Разберем, как задаются правила расчета.
OVER описывает окно. Эта конструкция указывает, что SUM используется как оконная функция. Если написать SUM(amount) OVER (), сумма будет рассчитана по всем строкам, прошедшим фильтр. В нашем примере рядом с каждой позицией появится 3 800 — общий объем оплаченных продаж.
PARTITION BY делит строки на независимые разделы. В выражении PARTITION BY category_id раздел соответствует категории: книги считаются отдельно от игр. При этом строки одного раздела не обязаны стоять рядом в итоговой таблице. В отличие от GROUP BY, такое разделение не сворачивает их в одну строку.
ORDER BY внутри окна задает порядок для вычисления. Например, позиции можно упорядочить по sale_id и последовательно накапливать их суммы. Тогда для книг сначала будет учтена позиция 1, затем позиция 3; для игр — сначала позиция 2, затем позиция 4.
Рамка уточняет, какие строки относительно текущей участвуют в расчете. Для накопления нужна рамка от начала раздела до текущей строки включительно:
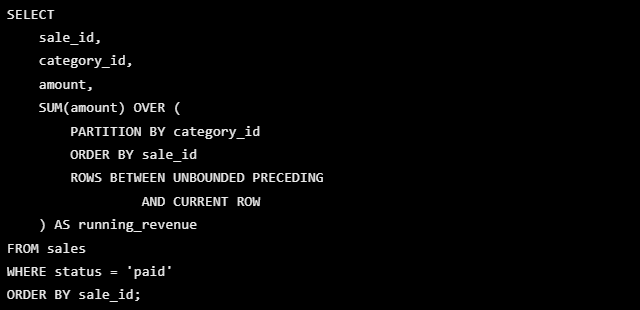
Для позиции 3 функция складывает 500 и 300: обе строки относятся к книгам и входят в рамку. Продажи игр в этот расчет не попадают. Так раздел определяет, какие строки связаны между собой, а рамка — какую часть раздела использовать для текущего вычисления.
В запросе два ORDER BY, и у них разные задачи. Внутри OVER сортировка определяет последовательность накопления. В конце запроса — порядок показа готовых строк. Если изменить только внешнюю сортировку, рассчитанные суммы останутся прежними. Если изменить порядок внутри окна, суммы могут измениться.
Практические примеры использования оконных функций
Теперь применим окна к отчету магазина. Для рейтинга возьмем таблицу category_totals с выручкой каждой категории за выбранный месяц. Для расчетов по дням — daily_sales, где одна строка соответствует одной дате и категории. Пока считаем, что эти суммы уже подготовлены; далее в разделе про CTE разберем, как получить их из отдельных продаж.
Рейтинг категорий
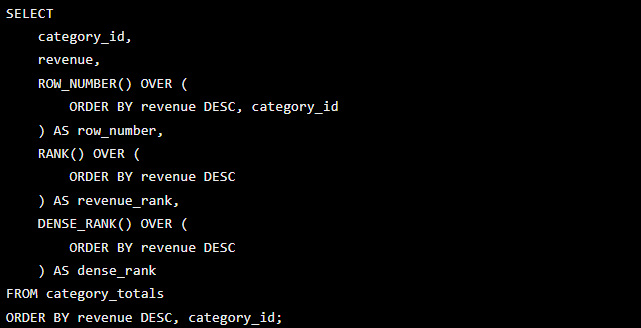
Допустим, нужно определить лидеров по выручке. Для этого подходят три функции, но при одинаковых значениях они ведут себя по-разному:
- ROW_NUMBER присваивает каждой строке отдельный порядковый номер.
- RANK назначает одинаковое место равным значениям, а следующие места пропускает с учетом числа таких строк.
- DENSE_RANK тоже назначает одинаковое место равным значениям, но продолжает нумерацию без пропусков.
Задание № 1. Три категории принесли 900, 900 и 700 рублей. Какие номера или места получит каждая, если отсортировать выручку по убыванию? Попробуйте ответить до просмотра таблицы.
| Категория | Выручка, ₽ | ROW_NUMBER | RANK | DENSE_RANK |
| A | 900 | 1 | 1 | 1 |
| B | 900 | 2 | 1 | 1 |
| C | 700 | 3 | 3 | 2 |
ROW_NUMBER дал каждой категории свой номер. Чтобы при равной выручке порядок был определен однозначно, мы добавили в сортировку уникальный category_id: категория A идет раньше B.
Для RANK и DENSE_RANK сортируем только по выручке, чтобы сохранить ничью. Обе функции отдали первое место категориям A и B. Но RANK поставил C на третье место, поскольку выше нее две категории, а DENSE_RANK — на второе: это второй по величине уровень выручки.
Поэтому просьбу «покажите топ 3» нужно уточнить. Если нужны ровно три категории, подойдет ROW_NUMBER с согласованным правилом разрешения ничьей. Если нужны категории с тремя наибольшими различными значениями выручки — DENSE_RANK. Во втором случае строк может оказаться больше трех. RANK пригодится, если места нужно назначать с пропусками, как в спортивном рейтинге.
Накопительная выручка
Следующий вопрос: сколько категория заработала с начала месяца к каждой дате? Чтобы получить в SQL накопительные итоги, зададим порядок по дням и рамку от начала раздела до текущей строки.
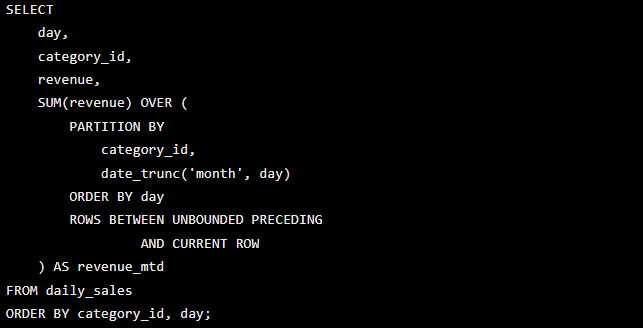
Фрагмент результата для одной категории:
| Дата | Дневная выручка, ₽ | Выручка с начала месяца, ₽ |
| 1 сентября | 100 | 100 |
| 2 сентября | 200 | 300 |
| 3 сентября | 0 | 300 |
| 4 сентября | 300 | 600 |
На 2 сентября сумма включает два дня: 100 + 200 = 300 рублей. На 3 сентября она не меняется, потому что продаж не было. На 4 сентября к ней добавляются еще 300 рублей.
В PARTITION BY указаны и категория, и месяц. Поэтому у каждой категории свое накопление, которое начинается заново при переходе к следующему месяцу. date_trunc(‘month’, day) сохраняет год и месяц: сентябрь разных лет не попадет в один раздел.
Для корректного итога в исходном наборе должны быть данные с начала месяца. Если перед расчетом оставить только даты с 10 сентября, функция начнет суммировать с 10-го числа.
Изменение относительно предыдущего дня
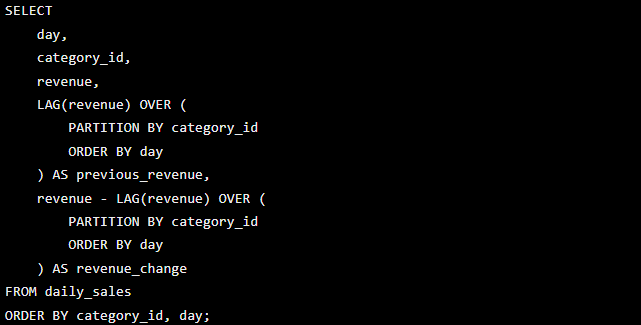
Чтобы получить значение из предыдущей строки, используем LAG. Затем вычтем его из текущей выручки.
| Дата | Выручка, ₽ | Предыдущее значение, ₽ | Изменение, ₽ |
| 1 сентября | 100 | NULL | NULL |
| 2 сентября | 200 | 100 | +100 |
| 3 сентября | 0 | 200 | −200 |
| 4 сентября | 300 | 0 | +300 |
У первой строки нет предыдущей, поэтому LAG по умолчанию возвращает NULL. Изменение тоже остается неизвестным. Подставлять вместо него ноль стоит только тогда, когда это соответствует правилам отчета: отсутствие данных еще не означает отсутствие продаж.
Обратите внимание: LAG берет предыдущую строку, а не ищет вчерашнюю дату. Если удалить из таблицы 3 сентября, функция сравнит 4 сентября со 2-м. Для дневной динамики нужен непрерывный календарь: одна строка на каждый день категории. Позже добавим его в итоговый запрос.
Скользящее среднее
Продажи могут заметно колебаться по дням. Чтобы сгладить отдельные всплески, рассчитаем скользящее среднее в SQL: для каждой даты возьмем выручку за текущий и шесть предыдущих дней.
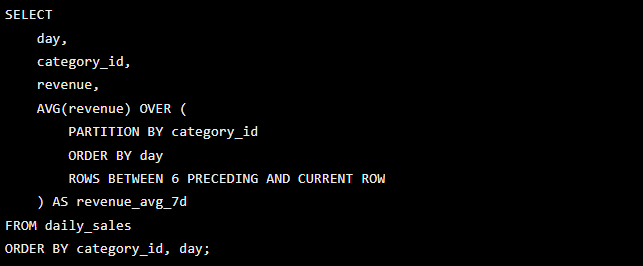
В этом примере у категории есть строка на каждый календарный день, в том числе на дни без продаж. Поэтому семь строк соответствуют семи дням.
| Дата | Выручка, ₽ | Среднее по доступным дням окна, ₽ |
| 1 сентября | 100 | 100 |
| 2 сентября | 200 | 150 |
| 3 сентября | 0 | 100 |
| 4 сентября | 300 | 150 |
| 5 сентября | 100 | 140 |
| 6 сентября | 0 | 116,67 |
| 7 сентября | 700 | 200 |
Среднее на 7 сентября включает значения 100, 200, 0, 300, 100, 0 и 700. Их сумма — 1 400 рублей; делим на семь и получаем 200 рублей. Нулевые дни участвуют в расчете, поэтому это средняя выручка за календарный день, а не только за дни с продажами. Значения в таблице округлены до двух знаков.
Для 8 сентября окно сдвинется: 1 сентября выйдет из расчета, а 8 сентября войдет. Так каждый следующий день получает свое среднее.
В начале набора данных предыдущих строк меньше шести. Функция AVG считает среднее по тем, которые есть: например, на 2 сентября — только по двум дням. Если полное недельное среднее нужно уже на 1 сентября, для расчета понадобятся данные начиная с 26 августа.
Типичные ошибки при работе с оконными функциями и как их избежать
- Считать показатель на неверной детализации.
Рамка ROWS BETWEEN 6 PRECEDING AND CURRENT ROW охватывает семь строк. Если строка соответствует товарной позиции, получится среднее по семи позициям, а не по дням. Перед расчетом определите, что означает одна строка, и при необходимости сгруппируйте данные.
- Не разрешить неоднозначность сортировки.
У двух покупок может совпасть время оплаты. Если использовать только ORDER BY paid_at, их взаимный порядок не определен: ROW_NUMBER может назначить номера по-разному. Добавьте уникальный идентификатор: ORDER BY paid_at, sale_id. Но для рейтинга с одинаковыми местами такой прием не подходит: дополнительный ключ устранит ничью.
- Перепутать ROWS и RANGE.
Допустим, на 1 сентября приходятся две продажи: 100 и 200 рублей, а на 2 сентября — еще 50. При накоплении через ROWS с однозначным порядком «дата, идентификатор» суммы будут 100, 300 и 350: каждая строка учитывается отдельно. При RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW с сортировкой только по дате получим 300, 300 и 350: обе строки за 1 сентября входят в рамку вместе.
RANGE также позволяет задавать диапазон значений, например интервал дат. Но он не создает отсутствующие дни. Если в диапазоне нет строки за день без продаж, AVG не включит этот день в знаменатель. Для среднего по календарным дням сначала нужен непрерывный ряд.
- Полагаться на рамку по умолчанию.
В PostgreSQL при оконном ORDER BY по умолчанию используется рамка от начала раздела до текущей строки и строк с равными значениями сортировки. Это особенно важно для LAST_VALUE: функция возвращает последнее значение рамки, а не обязательно всего раздела. Если нужно последнее значение раздела, задайте рамку явно: ROWS BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING, — и проверьте порядок сортировки.
- Фильтровать результат окна слишком рано.
В PostgreSQL WHERE применяется до оконных вычислений. Поэтому нельзя рассчитать ROW_NUMBER() … AS rn и на том же уровне написать WHERE rn <= 3. Сначала вычислите номера в подзапросе или CTE, затем отфильтруйте их во внешнем запросе.
Задание № 2. Аналитик оставил строки с 1 по 30 сентября через WHERE, а затем посчитал среднее за текущий и шесть предыдущих дней. Календарь полный, ошибок выполнения нет. Почему значения за начало месяца не соответствуют недельному среднему?
Окно видит только строки, которые прошли фильтр. На 1 сентября доступен один день, на 2 сентября — два. Августовская история уже исключена, и оконная функция не может ее восстановить.
Чтобы получить полный интервал, сохраните данные с 26 августа, рассчитайте среднее, а затем во внешнем запросе оставьте сентябрь. Такие задачи на оконные функции SQL полезно проверять на границах периода: именно там правильный на вид запрос часто дает неожиданный результат.
CTE (Common Table Expressions): делаем сложные запросы читаемыми
Когда подзапросы вложены друг в друга, приходится читать код изнутри наружу и держать в голове промежуточные результаты. Запрос можно организовать иначе: дать этим результатам имена и обращаться к ним на следующих этапах.
Что такое CTE и зачем они нужны
CTE — именованное табличное выражение, которое объявляется через WITH и используется внутри одной SQL-команды. Например, можно назвать результат группировки monthly_totals, а затем обратиться к нему при расчете рейтинга.
Такое имя объясняет, какие данные подготовлены на этапе. По названиям monthly_totals и ranked_categories проще восстановить логику, чем по t1 и t2. При этом CTE не создает постоянную таблицу: следующий независимый запрос уже не сможет обратиться к этому имени.
Нерекурсивные CTE — когда и как использовать
В отчете магазина нужно отобрать оплаченные позиции за сентябрь, посчитать выручку категорий, назначить места и оставить первые три. Разделим расчет на два именованных этапа:
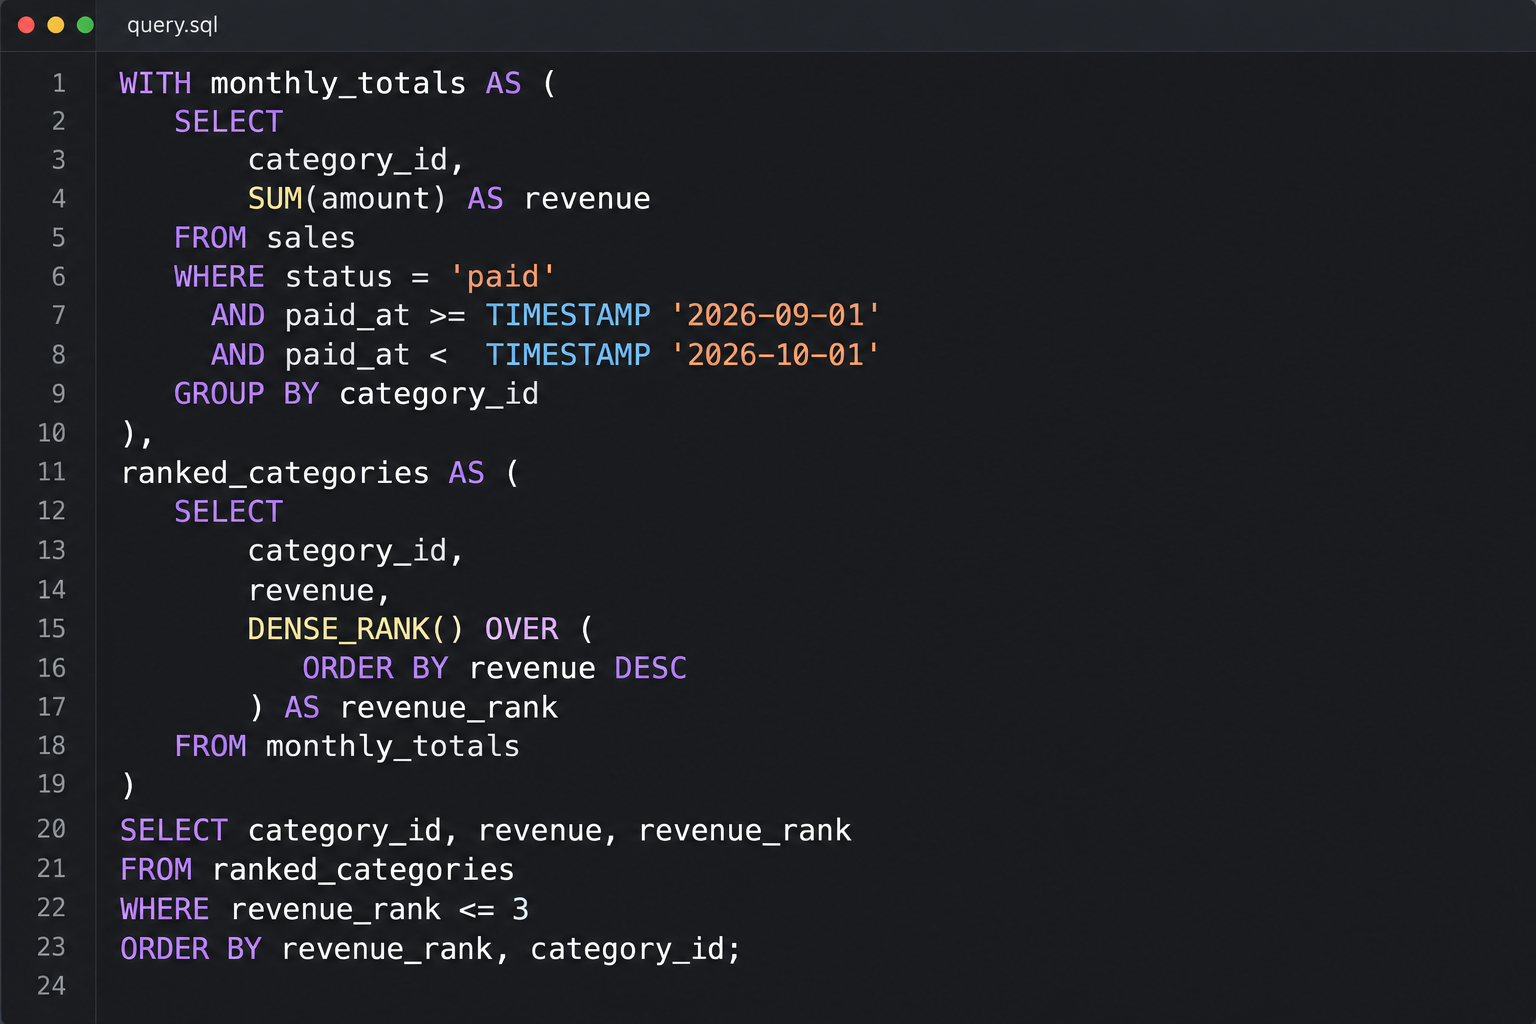
В monthly_totals получаем месячные суммы, в ranked_categories — места. Внешний запрос фильтрует уже рассчитанный рейтинг. При равной выручке в результат может попасть больше трех категорий.
Чтобы проверить промежуточные суммы, временно замените заключительный запрос на SELECT * FROM monthly_totals. Так можно найти ошибку до того, как переходить к проверке рейтинга.
Рекурсивные CTE — работа с иерархиями
У категорий магазина есть вложенность: электроника → компьютеры → ноутбуки. Если число уровней заранее неизвестно, найти всех потомков выбранной категории помогут рекурсивные CTE в SQL.
Возьмем справочник categories:
| category_id | name | parent_id |
| 10 | Электроника | NULL |
| 20 | Компьютеры | 10 |
| 30 | Ноутбуки | 20 |
| 40 | Смартфоны | 10 |
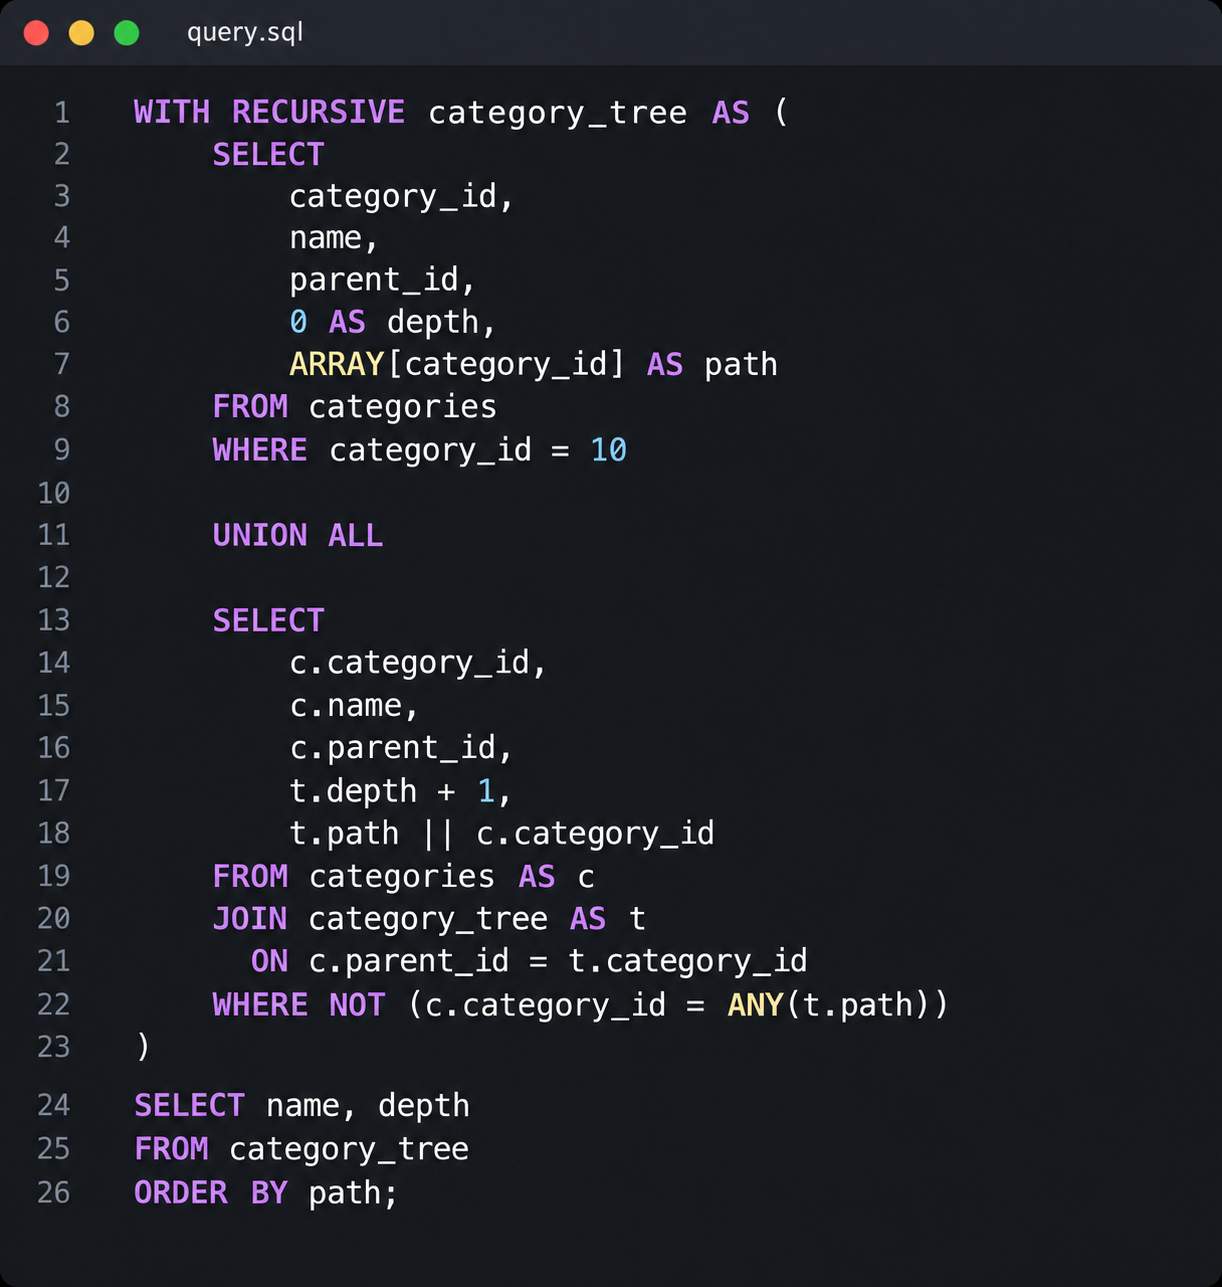
Начнем с электроники и будем последовательно находить дочерние категории:
| Категория | Глубина |
| Электроника | 0 |
| Компьютеры | 1 |
| Ноутбуки | 2 |
| Смартфоны | 1 |
Начальная часть выбирает категории электроники. На каждом шаге рекурсивная часть находит дочерние категории, соответствующие категориям, найденным на предыдущем шаге, и увеличивает значение глубины на единицу. Рекурсия завершается, когда новые строки не находятся.
Массив path хранит пройденные идентификаторы. Проверка через ANY не позволяет повторно посетить категорию на том же пути, если в данных возник цикл. Простая замена UNION ALL на UNION не всегда спасает от зацикливания: при изменении глубины строки остаются различными.
В нашем справочнике у категории не больше одного родителя. Если структура допускает несколько путей к одному узлу, решите, нужно ли учитывать его повторно. Иначе при последующем соединении с продажами можно задвоить суммы.
CTE vs подзапросы vs временные таблицы: что и когда использовать
| Инструмент | Когда использовать | Пример |
| Подзапрос | Для короткого вложенного вычисления | Сравнить сумму заказа со средним чеком |
| CTE | Для нескольких смысловых этапов одной команды | Посчитать выручку, построить рейтинг и отобрать лидеров |
| Временная таблица | Для набора, который нужен нескольким независимым командам | Подготовить дневные продажи для нескольких отчетов в одной сессии |
Особенности производительности CTE
Объявление через WITH не означает, что база обязательно сохранит промежуточный результат. В PostgreSQL 12+ нерекурсивный CTE без побочных эффектов при однократном использовании обычно встраивается в основной запрос. При нескольких обращениях по умолчанию обычно вычисляется отдельно.
Материализация — отдельное вычисление с сохранением результата для использования в рамках команды. Указание MATERIALIZED закрепляет этот вариант. NOT MATERIALIZED позволяет встроить подходящий CTE в основной запрос, но может привести к повторным вычислениям.
Выбор между общим набором и отдельными расчетами зависит от объема данных. Проверяйте его по плану выполнения.
Оптимизация производительности SQL-запросов
Оптимизация начинается с конкретного вопроса: что заставляет этот запрос работать медленно? Возможно, он читает слишком много строк, повторяет вычисления или тратит время на сортировку.
Почему запрос тормозит и как это диагностировать
В PostgreSQL команда EXPLAIN (ANALYZE, BUFFERS) выполняет запрос и показывает, сколько строк обработано, сколько раз запускался каждый узел и куда ушло время. Ищите повторные чтения, расхождения между ожидаемым и фактическим числом строк, сортировки на диске.
Оптимизация оконных функций
Сократите входной набор: отберите нужный период и сгруппируйте продажи до дня, если показатель требует такой детализации. Сохраните историю для скользящего среднего. Чем меньше строк и ненужных столбцов обрабатывает окно, тем меньше ресурсов может потребоваться.
Оптимизация запросов с CTE и подзапросами
Проверьте, не вычисляется ли один результат многократно и не размножаются ли строки после соединений. Переносите фильтры ближе к чтению данных, если это сохраняет смысл расчета. После изменений сравните результаты, планы и время: замена подзапроса на CTE сама по себе ускорения не гарантирует.
Практический кейс: как ускорить запрос в 10 раз
Допустим, для каждого дня категории запрос заново суммирует выручку с начала месяца через коррелированный подзапрос. Если план показывает, что этот расчет повторяется для каждой строки, база многократно обрабатывает пересекающиеся наборы данных.
Заменим подзапрос на SUM(revenue) OVER (…): разделим строки по категории и месяцу, упорядочим по дате и зададим рамку от начала раздела до текущей строки. На входе должна быть одна строка на день категории.
Сначала проверим совпадение результатов, затем несколько раз выполним обе версии на одинаковых данных при сопоставимой нагрузке. Если медианное время снизится с 20 до 2 секунд, получим десятикратное ускорение.
Это учебный сценарий, а не результат замера: конкретный выигрыш нужно подтвердить экспериментом. В плане проверяем, исчезли ли повторные вычисления и сколько времени теперь занимает сортировка.
Собираем все вместе: сложный запрос, который работает быстро
Вернемся к задаче из начала статьи. Магазину нужен ежедневный отчет, в котором можно сравнить категории и проследить динамику продаж. Пройдем весь расчет — от отдельных товарных позиций до таблицы с готовыми показателями.
Пошаговый пример: расчет витрины данных с рейтингом и накопительными итогами
Соберем пример сложного SQL-запроса для отчета за сентябрь. Одна строка результата — одна категория в один день. Рядом с выручкой покажем изменение относительно вчерашнего дня, среднее за неделю, сумму с начала месяца и место в дневном рейтинге.
Используем таблицу sales с товарными позициями и справочник categories, где каждой категории соответствует уникальный category_id. Считаем только позиции со статусом paid; сумма amount учитывает количество и скидку, а время оплаты paid_at уже приведено к часовому поясу бизнеса. Все категории продаж присутствуют в справочнике.
Шаг 1. Подготовим период и дневные суммы. Для полного недельного среднего на 1 сентября нужны данные с 26 августа. Отберем оплаченные позиции за этот период и сгруппируем их по дате и категории.
Шаг 2. Добавим дни без продаж. Построим календарь, соединим его со справочником категорий и подставим дневные суммы. Там, где продаж не было, поставим ноль. Предполагаем, что категории существовали весь период, а данные полностью загружены.
Шаг 3. Рассчитаем показатели. Для среднего и сравнения со вчерашним днем сохраним августовскую историю. Накопительную сумму разделим дополнительно по месяцам, чтобы сентябрь начинался с нуля. Для рейтинга будем сравнивать категории внутри каждого дня.
Шаг 4. Оставим даты отчета. Отфильтруем сентябрь после оконных вычислений и добавим названия категорий.
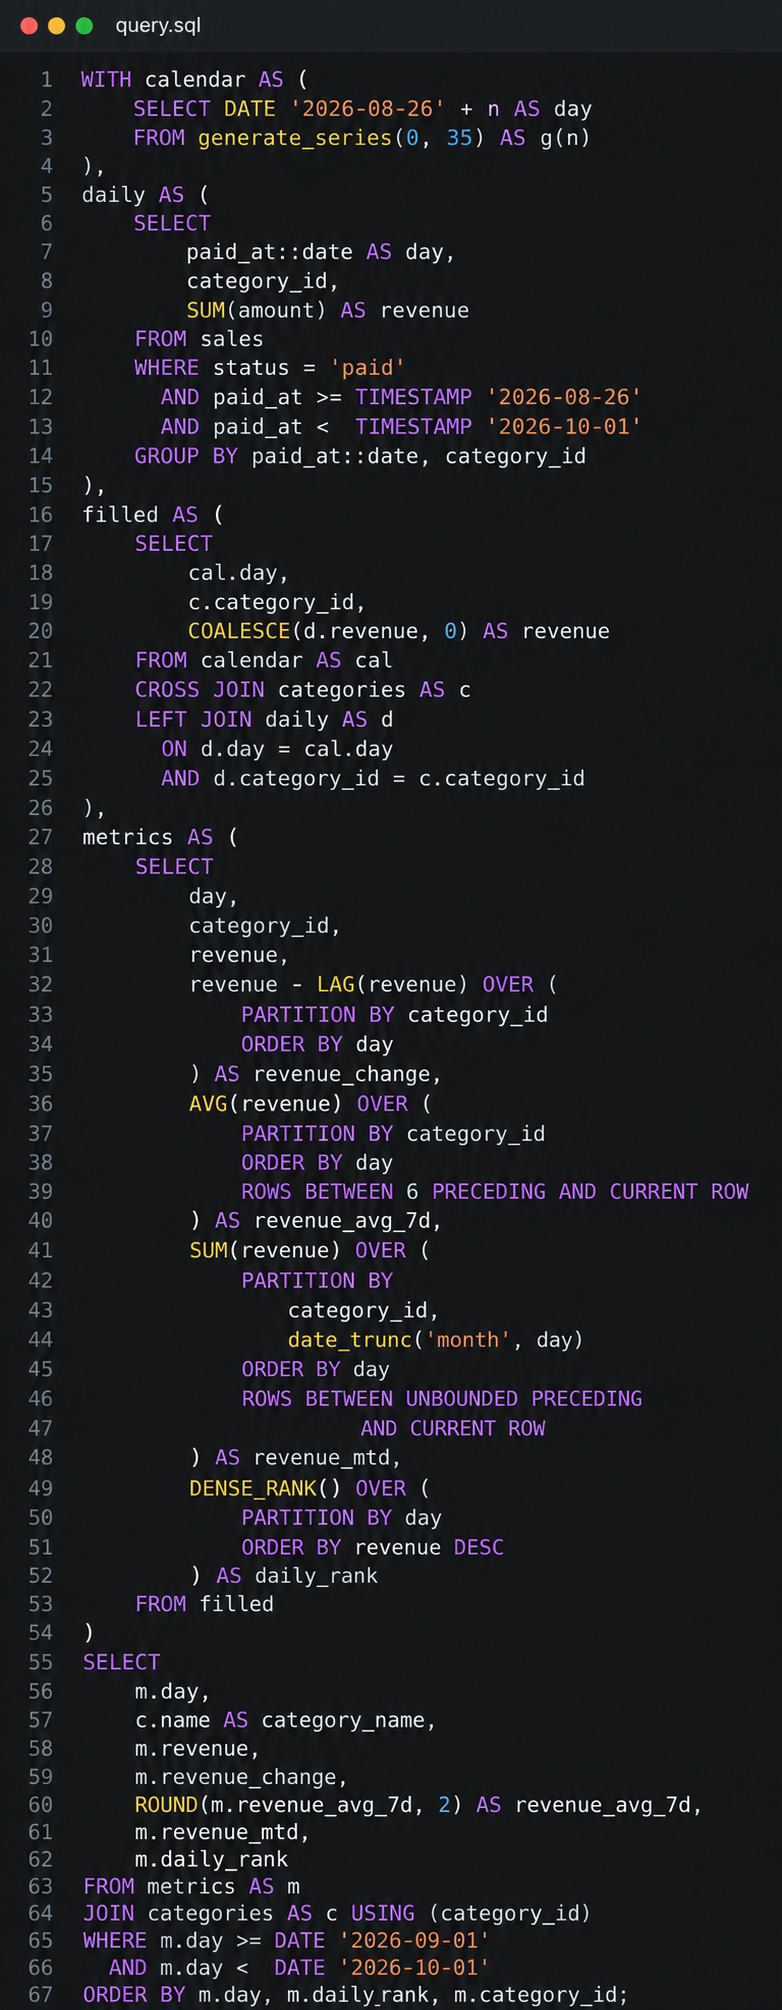
Посмотрим на возможный фрагмент результата. Допустим, в магазине две категории — книги и игры. За 26–31 августа продажи книг составили 100, 200, 0, 300, 100 и 0 рублей, а продажи игр — по 200 рублей ежедневно. В сентябре получились следующие показатели:
| Дата | Категория | Выручка, ₽ | Изменение, ₽ | Среднее за 7 дней, ₽ | С начала месяца, ₽ | Место |
| 1 сентября | Книги | 700 | +700 | 200 | 700 | 1 |
| 1 сентября | Игры | 400 | +200 | 228,57 | 400 | 2 |
| 2 сентября | Игры | 600 | +200 | 285,71 | 1 000 | 1 |
| 2 сентября | Книги | 0 | −700 | 185,71 | 700 | 2 |
Разберем книги за 1 сентября. Выручка — 700 рублей, накануне продаж не было, поэтому изменение равно +700. Среднее учитывает шесть августовских дней и 1 сентября: 1 400 / 7 = 200 рублей. Накопительная сумма включает только сентябрь и равна 700. Это больше выручки игр за тот же день, поэтому книги занимают первое место.
Запрос сначала сокращает товарные позиции до дневных сумм и только потом рассчитывает окна. При 100 категориях календарная сетка содержит 3 600 строк независимо от числа покупок. Это уменьшает объем оконных вычислений, но время чтения исходных продаж все равно нужно проверить по плану.
Перед использованием витрины убедитесь, что на каждую категорию приходится 30 сентябрьских строк, месячная выручка совпадает с независимым расчетом, а итог на 30 сентября равен сумме за месяц. Отдельно проверьте полноту загрузки: ноль должен означать отсутствие продаж, а не потерянные данные.
Задание № 3. Что нужно изменить, чтобы получить среднее за 14 дней уже на 1 сентября?
Недостаточно заменить 6 PRECEDING на 13 PRECEDING. Понадобятся еще 13 дней истории: начало календаря и отбора продаж нужно перенести на 19 августа. Для календаря до 30 сентября включительно используйте generate_series(0, 42). Финальный фильтр остается прежним — в отчете показываем только сентябрь.
Как прокачать навыки работы с SQL на практике
Понять запрос легче, чем построить его по описанию задачи. Пройдите путь самостоятельно: определите показатель, выберите детализацию, напишите расчет и проверьте пограничные случаи.
Для такой практики подойдет симулятор Data Science. Это тренажер по анализу данных, машинному обучению и ИИ с более чем 100 бизнес-задачами и тремя уровнями сложности. Есть тематические подборки, в том числе по SQL и метрикам. Можно выбирать задания под свой уровень и постепенно усложнять работу.
На платформе можно изучить теорию, отправить решение на автоматическую проверку, получить обратную связь и сравнить подход с авторским. Вопросы можно обсуждать с экспертами и другими участниками. Для старта нужны базовые знания Python, SQL и статистики; знания машинного обучения нужны для соответствующего направления.
Заключение
Как понять, что вы готовы применять эти инструменты в работе? Попробуйте решить похожую задачу без готового запроса: уточнить показатель, выбрать детализацию, разбить вычисления на этапы и проверить ответ. Если результат оказался неожиданным, найдите, на каком шаге он изменился.
Необязательно помнить все конструкции наизусть. Важнее понимать, какие данные нужны расчету и как проверить его правильность. Синтаксис можно уточнить в документации, а привычка разбираться в условиях задачи формируется с практикой.