
Graph RAG: как графы знаний повышают точность ответов LLM
Вы спрашиваете бота, можно ли вернуть товар, купленный в рассрочку, а он присылает общую инструкцию. Нужные сведения есть в базе, но система не связала условия покупки с правилами возврата. С такими задачами помогает особый подход, который учитывает связи между данными. Разберем основы GraphRAG: как устроены графы знаний, как они помогают моделям LLM отвечать точнее и когда стоит использовать эту технологию.
Содержание
Найти информацию — еще не всё
Чтобы ответить на вопрос, нейросети нужны подходящие сведения. Но даже если они есть в документах, система может найти лишь часть нужной информации. Расскажем, как устроен этот поиск, зачем в RAG нужна векторная база и почему найденных фрагментов иногда недостаточно для полного ответа.
Что такое RAG и как он работает
Нейросеть не знает, что написано во внутренних документах вашей компании или какие условия доставки вы изменили вчера. Если задать ей вопрос об этом без дополнительных данных, она может дать устаревший ответ или придумать правдоподобное объяснение.
RAG (Retrieval-Augmented Generation) — подход, при котором система сначала ищет информацию во внешних источниках, а затем передает ее языковой модели вместе с вопросом. По-русски это называют генерацией с дополнением на основе поиска. Источниками могут быть инструкции, статьи, договоры или база знаний компании. Модель получает материалы для ответа прямо во время запроса, и переобучать ее для этого не нужно.
Векторный поиск помогает находить фрагменты, близкие по смыслу к вопросу.
- Документы делят на фрагменты и преобразуют их в наборы чисел — векторы.
- Вопрос пользователя тоже становится вектором.
- Система находит близкие по смыслу фрагменты и передает их вместе с вопросом языковой модели, которая составляет ответ.
Три ограничения векторного RAG
В некоторых ситуациях базового поиска не хватает.
1. Связанные сведения не всегда похожи на вопрос.
Допустим, сотрудник спрашивает, кто отвечает за сервис. В техническом описании указана команда, а имя ее руководителя находится в другом документе. Чтобы ответить, нужно сначала найти команду, а затем — человека.
Поиск по исходному вопросу может вернуть описание сервиса, но пропустить документ о составе команды. Векторная близость сама по себе не задает маршрут по таким связям. Его нужно организовать дополнительно.
2. При делении текста могут потеряться важные условия
Правило и исключение из него могут оказаться в разных областях. Например, один фрагмент сообщает, что сотрудники могут работать удаленно, а другой уточняет, для каких должностей нужно согласование.
Если система найдет только общее правило, ответ получится неполным. Она просто не получила нужный фрагмент.
3. Нескольких подходящих фрагментов мало для общей картины
На вопрос «Какие проблемы чаще всего упоминают клиенты?» недостаточно найти несколько похожих обращений. Нужно охватить весь набор отзывов, выделить повторяющиеся темы, а для оценки частоты — еще и подсчитать упоминания.
Базовый векторный поиск выбирает ограниченное число ближайших фрагментов. Они могут хорошо соответствовать вопросу, но не отражать всю совокупность данных. Ответ по такой выборке рискует пропустить значимые темы.
Эти ограничения не означают, что векторный поиск RAG бесполезен. Его можно улучшать: точнее делить документы, учитывать метаданные, выполнять несколько поисковых запросов.
Graph RAG: новый подход к дополненной генерации
Еще один способ сделать поиск полнее — учитывать связи между данными. В апреле 2024 года исследователи Microsoft опубликовали работу, в которой описали, как собирать разрозненные сведения в общий контекст.
Что такое граф знаний и как он устроен
Граф знаний — это способ представить информацию через объекты и связи между ними. Его основу составляют:
- Узлы — сущности: люди, компании, продукты, документы или понятия.
- Ребра — связи между сущностями: «руководит», «входит в состав», «зависит от», «описывает».
- Свойства — дополнительные сведения: имя сотрудника, дата документа, версия продукта. Свойства могут быть и у связей: например, дата назначения человека руководителем.
Возьмем три факта: Анна руководит командой «Платформа», а команда поддерживает сервис оплаты. В графе Анна, команда и сервис станут отдельными узлами. Между ними появятся связи «руководит» и «поддерживает».
Теперь на вопрос «Кто руководит командой, отвечающей за оплату?» система сможет найти сервис, перейти к его команде, а затем — к Анне. Для этого имя Анны и название сервиса необязательно должны встречаться в одном фрагменте текста.
Граф можно построить из готовых структурированных данных или извлечь сущности и отношения из документов с помощью LLM. Во втором случае результат нужно проверять: модель может перепутать одноименные организации или добавить связь, которую источник не подтверждает. Поэтому полезно сохранять, откуда получен каждый факт.
Как Graph RAG решает проблемы векторного подхода
Если кратко, то участвует в подборе контекста для языковой модели. При этом векторный поиск может оставаться частью системы: он находит отправную точку, а связи помогают собрать дополнительные сведения.
Находит сведения через связи. Найдя сервис оплаты, система может перейти к поддерживающей его команде и ее руководителю. Так в контекст попадают факты, которые нужны для ответа, даже если их описания мало похожи на исходный вопрос. Какие связи использовать и насколько далеко по ним идти, задается логикой поиска.
Помогает собрать условия из разных фрагментов. Общее правило, исключение и документ с уточнениями можно связать в графе. Тогда при поиске правила система сможет извлечь и связанные с ним ограничения. Это снижает риск ответа без важной оговорки — при условии, что нужные отношения были корректно выделены и учтены при поиске.
Поддерживает обзор больших массивов документов. В некоторых архитектурах, включая Microsoft GraphRAG, связанные сущности объединяют в сообщества и заранее создают их текстовые резюме. Для обзорного вопроса система может использовать эти обобщения, чтобы охватить больше тем, чем при поиске нескольких отдельных частей. Однако для точного подсчета упоминаний все равно нужны отдельные вычисления.
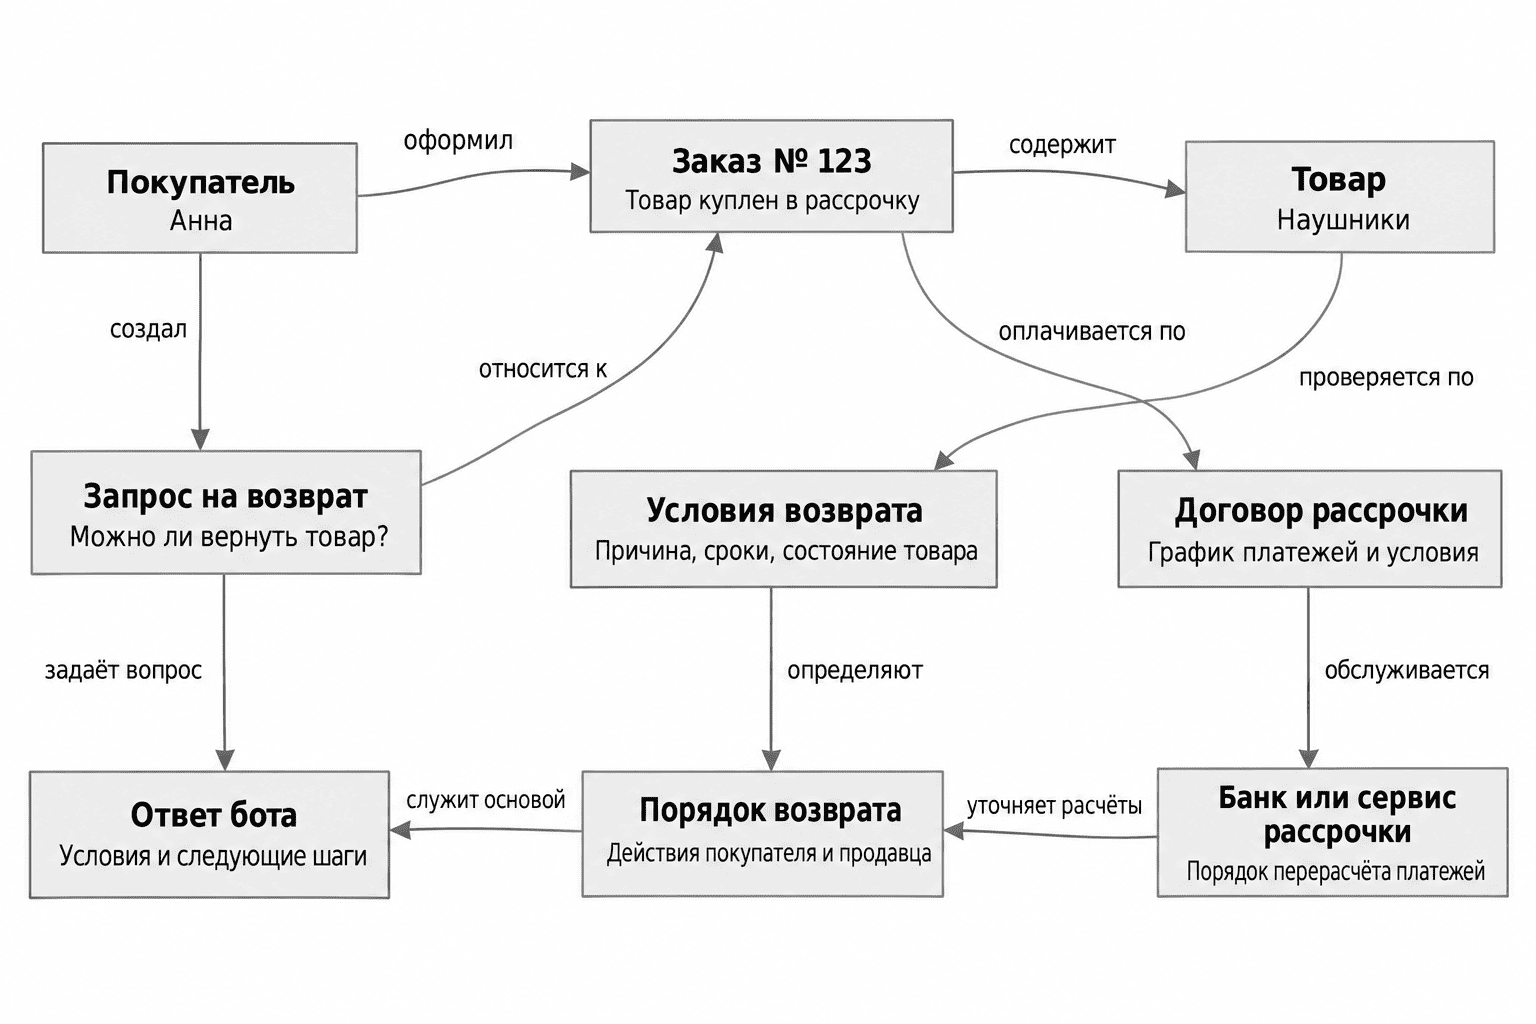
Пример графа знаний для бота, который подскажет пользователю, как вернуть купленный в рассрочку товар
В итоге LLM получает отобранные факты, описания отношений и фрагменты источников. На их основе она составляет ответ. Граф помогает сделать контекст полнее, но не гарантирует правильность: пропущенные сущности, ошибочные связи и устаревшие сведения тоже могут попасть в ответ.
Конвейер Graph RAG: от документов к ответу
Разберем все этапы на примере Microsoft GraphRAG — открытого проекта с подробной документацией. Его архитектура позволяет проследить весь путь от исходных документов до готового ответа. Но учтите, что в других реализациях набор шагов может отличаться.
Индексация — построение графа знаний
Начинаем с подготовки документов к поиску. На этом этапе система извлекает из текстов сущности и отношения, объединяет их в граф и создает обобщения. Все это происходит заранее, до вопросов пользователя.
Шаг 1. Чанкинг текста
Документы разбивают на небольшие фрагменты — чанки. Их размер и перекрытие настраивают так, чтобы модели было удобно обрабатывать текст. Каждый фрагмент сохраняет связь с исходным документом: она понадобится для проверки найденных сведений.
Шаг 2. Извлечение сущностей и связей с помощью LLM
Языковая модель читает чанки и выделяет сущности, их типы, описания и отношения. Например, из предложения «Компания „Вектор“ открыла офис в Казани» можно извлечь организацию, город и связь между ними.
Шаг 3. Формирование подграфов
Из сведений каждого чанка получается небольшой подграф: сущности становятся узлами, отношения — ребрами. Так структура данных графа позволяет явно записать, какие объекты связаны и что известно об этих связях.
Шаг 4. Объединение в глобальный граф
Подграфы собирают вместе. В стандартном конвейере Microsoft сущности объединяются по совпадению названия и типа, а связи — по совпадению конечных узлов. Накопленные описания обобщает LLM.
Здесь нужна проверка, ведь одинаковые названия не всегда обозначают один объект, а разные названия могут относиться к одной компании
Шаг 5. Кластеризация (Leiden algorithm)
Далее система ищет сообщества — группы узлов, тесно связанных между собой. Для этого используется иерархический алгоритм Leiden: он выделяет крупные группы и более мелкие внутри них. Такая организация помогает рассматривать данные с разной степенью подробности.
Шаг 6. Создание резюме сообществ
Для каждого сообщества LLM составляет текстовое резюме: описывает основные сущности, отношения и значимые сведения. Получается своего рода справка по группе связанных объектов.
Эти резюме готовят заранее, чтобы затем использовать для обзорных вопросов. Например, для ответа о главных темах коллекции документов системе пригодятся обобщения нескольких сообществ. Они позволяют охватить разные части данных, не передавая модели все исходные тексты целиком.
Извлечение — поиск по графу
Когда пользователь задает вопрос, система обращается к подготовленным данным.
Локальный поиск подходит для вопросов о конкретных объектах. Например: «С какими организациями сотрудничает компания „Вектор“?»
Сначала векторный поиск находит сущности, близкие по смыслу к вопросу. Они становятся точками входа в граф. Затем система собирает связанные сущности, отношения, фрагменты исходных документов и при необходимости резюме сообществ. Найденные материалы ранжируются и фильтруются, чтобы поместиться в доступный модели контекст. Таким образом, графовый и векторный поиск RAG работают вместе.
Глобальный поиск помогает отвечать на обзорные вопросы. Например: «Какие проблемы обсуждаются в отчетах компании?»
Он использует резюме сообществ на выбранном уровне детализации. Система обрабатывает их порциями, а LLM выделяет из каждой порции сведения, полезные для ответа. Затем наиболее значимые результаты объединяются. Это позволяет рассмотреть разные темы корпуса документов, а не ограничиваться несколькими похожими фрагментами.
Генерация ответа на основе контекста
На заключительном этапе языковая модель получает вопрос и подготовленный контекст. При локальном поиске это могут быть описания сущностей, отношения и исходные фрагменты. Модель превращает их в связное объяснение на языке пользователя. Ей не требуется «смотреть» на визуальную схему графа: сведения передаются в текстовом или табличном виде.
При глобальном поиске генерация происходит в несколько проходов: сначала появляются промежуточные ответы по отдельным порциям резюме, затем из отобранных результатов составляется итоговый ответ. Поэтому поиск и генерация здесь тесно переплетены.
В инструкции для модели стоит закрепить простое правило: опираться на найденные сведения, указывать источники и сообщать, если данных недостаточно. Это не заменяет проверку качества, но помогает сделать ответы полезнее и прозрачнее для читателя.
Graph RAG vs Vector RAG: сравнение подходов
Выбор подхода начинается с задачи: какие вопросы будут задавать пользователи и где хранятся ответы на них? В одних случаях хватит поиска похожих фрагментов, в других пригодятся явно заданные связи.
Сравнение по ключевым критериям
| Векторный RAG | Graph RAG | |
| Как ищет информацию | Находит фрагменты, близкие по смыслу к вопросу | Использует связи между сущностями, часто в сочетании с векторным поиском |
| Для каких вопросов подходит | Ответ находится в одном или нескольких подходящих фрагментах | Ответ требует связать сведения из разных источников; архитектуры с резюме сообществ также помогают с обзорными вопросами |
| Подготовка данных | Разбиение документов на чанки, создание эмбеддингов и поискового индекса | Дополнительно нужны построение графа и проверка связей; в некоторых архитектурах — создание резюме сообществ |
| Затраты на внедрение | Обычно проще запустить базовую систему | Обычно требует больше работы с данными и настройки поиска |
| Обновление | Можно переиндексировать измененные фрагменты | Нужно учитывать изменения сущностей, связей и зависящих от них резюме |
| Скорость ответа | Зависит от поиска, отбора фрагментов и генерации | Зависит от сложности поиска; многоэтапная обработка резюме может увеличивать задержку |
| Проверяемость | Ответ можно сопоставить с найденными фрагментами | Дополнительно можно проследить связи между фактами, если сохранены ссылки на источники |
| Основные риски | Важный фрагмент не найден или извлечен без нужных уточнений | Ошибки извлечения и объединения сущностей, пропущенные или устаревшие связи |
| Качество ответов | Зависит от полноты и релевантности найденного контекста | Может быть выше в задачах на связи и обобщение, но преимущество нужно проверять на своих данных |
Когда Graph RAG — правильный выбор
Graph RAG стоит рассмотреть, если для ответов регулярно нужно прослеживать зависимости и объединять сведения из разных документов. Например, выяснять, какие продукты затронет изменение компонента или какие организации связаны с проектом. Подходы с резюме сообществ полезны и для обзора больших коллекций текстов. При этом команда должна быть готова проверять граф и поддерживать его актуальность.
Когда стоит оставить векторный RAG
Векторного RAG часто достаточно, если пользователи ищут конкретные сведения в инструкциях, статьях и справочниках, а система уже отвечает с нужным качеством. Если ответы неполные, сначала стоит проверить разбивку документов, фильтры и отбор найденных фрагментов. Переход к графу оправдан, когда он дает измеримую пользу, сопоставимую с затратами на внедрение и поддержку.
Создание AI-агентов с Graph RAG: следующий уровень
Поиск по графу знаний можно сделать одним из инструментов AI-агента. Тогда система сможет выбирать, какие сведения запросить, проверять, достаточно ли их для решения задачи, и при необходимости продолжать искать данные.
От RAG-системы к умному AI-агенту
В базовой RAG-системе последовательность действий задана заранее: найти информацию, собрать контекст, сформировать ответ. AI-агент может выбирать следующий шаг с помощью LLM, учитывая задачу и результаты предыдущих действий.
Например, сначала агент найдет в графе поставщика нужного товара, затем запросит остатки через внешний сервис и подготовит рекомендации. Graph RAG обеспечивает его связанными сведениями, а логика агента определяет, когда и зачем к ним обращаться. Само добавление графа еще не превращает систему в умного ассистента.
Как проектировать агентов, работающих с графами знаний
Сначала ответьте, что агент должен выяснять и какие действия ему разрешены? Затем определите, какие сущности и связи нужны в графе, и предоставьте инструменты поиска с понятными правилами использования.
Заранее продумайте, что делать при нехватке данных, противоречиях или ошибках. Ограничьте число поисковых шагов, настройте доступ к сведениям и подтверждение значимых действий человеком. Проверяйте на типовых запросах и итоговый ответ, и путь к нему: какие инструменты интеллектуальный помощник выбрал и на какие источники опирался.
Где научиться создавать таких агентов: курс «Создание ИИ-агентов» от Karpov.Courses
Для работы над такими системами пригодятся навыки подготовки данных, настройки поиска и подключения инструментов к LLM. Освоить базу можно на курсе «Создание ИИ-агентов».
За две недели вы пройдете путь от сборки ассистента без кода до простого Python-бота: настроите поиск по документам, подключите внешние сервисы через MCP и создадите Telegram-интерфейс. В программе — LangChain, локальные модели через Ollama и векторная база pgvector. Эти навыки помогут перейти к собственным экспериментам с более сложными системами поиска.
От идеи до MVP: как ИИ меняет создание цифровых продуктов
Практические шаги по внедрению Graph RAG
Начните с небольшого набора документов и вопросов, на которых обычный поиск дает неполные ответы. Такой пилот поможет проверить пользу графа до масштабного внедрения. Для него нужно выбрать способ хранения данных, настроить извлечение сущностей и проверить, правильно ли система выстроила связи.
Выбор графовой базы данных (Neo4j, Memgraph, Spanner Graph)
Отдельная графовая СУБД нужна не каждой реализации Graph RAG. Но если вы планируете регулярно обновлять связи и выполнять запросы к графу, стоит рассмотреть специализированные инструменты.
| Инструмент | Возможности | Когда стоит рассмотреть |
| Neo4j | Запросы на языке Cypher, графовые алгоритмы, векторные индексы и инструменты интеграции с LLM | Когда важны готовые инструменты для построения Graph RAG и развитая экосистема |
| Memgraph | Поддержка Cypher, работа с потоковыми данными, библиотека графовых алгоритмов MAGE | Когда граф часто обновляется и нужно анализировать поступающие данные |
| Spanner Graph | Графовые возможности облачной СУБД Spanner, совместное использование табличной и графовой моделей, запросы на GQL | Когда проект работает в Google Cloud и требует распределенного хранения и масштабирования |
Выбирайте по требованиям проекта: объему данных, частоте обновлений, доступным ресурсам и стоимости эксплуатации. Проверьте на пилоте скорость типовых запросов и удобство поддержки.
Заранее решите, где хранить эмбеддинги — числовые представления текстов, которые система использует для поиска по смыслу. Можно использовать встроенный векторный поиск выбранной СУБД или отдельные векторные базы для RAG. Во втором случае понадобятся общие идентификаторы, чтобы связывать результаты поиска с нужными узлами графа.
Интеграция с LLM для извлечения сущностей
Прежде чем подключать модель, определите, какие объекты и отношения нужны для ваших задач. Например, для поиска по проектной документации пригодятся сотрудники, команды, сервисы и связи «отвечает за» или «зависит от».
Далее настройте обработку документов:
- Задайте формат результата. Попросите модель возвращать сущности и связи в структурированном виде, например в JSON, с указанием типов и подтверждающих фрагментов.
- Добавьте примеры. Покажите, как извлекать отношения, обрабатывать сокращения и отличать факт от предположения.
- Проверяйте перед записью. Контролируйте формат, допустимые типы связей и дубликаты. Сохраняйте ссылки на исходные документы.
- Оцените качество на небольшой выборке. Сравните результат с ручной разметкой: какие сущности модель пропустила, какие объединила ошибочно и какие отношения добавила без оснований.
Выбирайте модель по результатам этой проверки. Для проекта важны не только качество извлечения, но и стоимость обработки, скорость и условия работы с внутренними документами.
Визуализация графов для отладки
Представление объектов базы данных в графах помогает заметить ошибки, которые трудно увидеть в списках записей. Например, одна компания может оказаться разбита на несколько узлов из-за разных написаний названия, а два однофамильца — ошибочно объединены.
Для просмотра можно использовать Neo4j Browser или Memgraph Lab. Начните с небольшого участка графа вокруг конкретной сущности или вопроса пользователя. Проверьте, есть ли нужные связи, верно ли их направление и подтверждаются ли они источниками.
Визуальную проверку дополните тестовыми вопросами. Сравните ответы с базовым векторным поиском, оцените полноту, наличие ошибок, задержку и стоимость. Это покажет, помогает ли построенный граф решать вашу задачу.
Заключение
Точность ответа зависит от того, какие сведения получила языковая модель. Graph RAG расширяет возможности поиска: помогает учитывать отношения между объектами и объединять информацию из разных документов. Насколько это улучшит вашу систему, покажет практика — тестовые вопросы, проверка источников и сравнение с базовым решением.
